


オブザーバビリティと監視の違い。アラートの後、何を調べるか
監視で API エラーの増加を捉えたあと、メトリクス、トレース、ログを使って原因の候補を絞る流れを解説します。
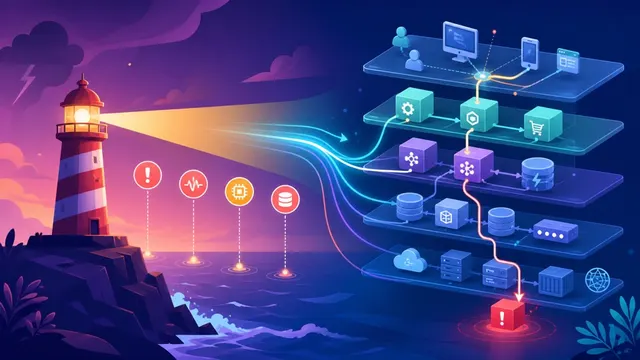
リリース直後から、決済 API の 5xx が増え始めたとします。アラートを見れば、エラー率がしきい値を超えた時刻と、最初に見るべき箇所が分かります。どのリクエストが失敗したのか、そのリクエストに何が共通しているのか、リリースが関係したのかは、ここから調べます。
監視は、システムの動作を継続的に記録し、変化を把握する取り組みです。オブザーバビリティ(可観測性)は、システムが出すデータから内部の状態をどこまで読み取れるかを表します。 どちらにも同じテレメトリーを使えます。監視ルールが初めて見る障害の兆候を捉え、そのルールで使ったメトリクスが調査の出発点になることもあります。
監視で何が分かるか
監視するなら、利用者にとって意味のある変化を測り、当番がどこから調べればよいか分かるようにします。決済 API の 5xx 率なら、同じルート、同じ期間を対象に、5xx の応答数を集計対象の全応答数で割ります。たとえば、リクエスト数が一定以上あり、5xx 率が 2% を超える状態が複数回の評価にわたって続いたときに通知します。2% は例です。しきい値と期間は、実際のトラフィック、利用者への影響、当番に求める対応に合わせて決めます。
ホストのリソース飽和、API の成功率、外形監視の結果、注文数も監視できます。通知が要らない指標でも、ダッシュボードで推移を追う意味はあります。サービスレベル目標(SLO)は信頼性の目標で、サービスレベル指標(SLI)はサービスの実績を測る指標です。監視では SLI とエラーバジェットの消費ペースを追えます。 Google SRE の分散システム監視
リリースを疑う前に、エラー率を分けて見る
一つのアラート期間について、次のような件数が得られたとします。どちらのバージョンも同じルートを処理しています。
| バージョン | 全応答数 | 5xx の件数 | 5xx 率 |
|---|---|---|---|
| 旧バージョン | 4,000 | 20 | 0.5% |
| 新バージョン | 1,000 | 100 | 10% |
| 全体 | 5,000 | 120 | 2.4% |
全体では 5,000 件中 120 件、つまり 2.4% です。バージョン別に見ると、次に調べる範囲が絞れます。ただし、新バージョンを一つのリージョンだけで動かしていたなら、影響を受けなかったリクエストと比べ、リージョンや下流の依存先も確認します。比率の計算には応答の集計値を使います。エラーを優先して抽出したトレースは共通点を探すのに使えますが、全体のエラー率はそこから求められません。
両方のグループから保存済みのトレースを何件か開きます。たとえば、新バージョンのリクエストでは在庫サービスへの再試行に大半の時間を使い、正常なリクエストは初回で応答を得ているかもしれません。再試行や期限の設定変更が候補になります。二つの設定と依存先のデータを比較し、実際に説明がつくかを確かめます。 Google SRE のトラブルシューティング
次の調査に使う情報を残す
Guance ではモニターイベントに関連リンクを追加して、検知対象の期間と関連するフィルターをエクスプローラーに引き継げます。保存されているトレースなら、トレースの詳細で関連ログを確認できます。トレース全体のログは、既定で trace_id を使って関連付けます。service、env、version などの項目はログインデックスの選択に使われます。span_id も記録しておくと、そのログがどのスパンに対応するかを確認できます。ログとトレースの関連付けを設定し、対象のインデックスにアクセスできることを確かめます。確認できるのは、収集され、保存期間内にあるデータです。サンプリングで除外されたトレースは表示されません。
調査中に浮かんだ仮説は、その場でクエリを書いて確かめます。たとえば、対象期間に収集したエラーを、取得済みのバージョンやリージョンの項目で集計できます。記録されていない項目をクエリで復元することはできません。
メトリクスのラベルには、まずサービス、ルートテンプレート、リージョンなど、値の種類が限られる項目を使います。バージョンは、調査に役立ち、同時に使う値の数を管理できる場合に加えます。個々のリクエスト ID は、保存期間やアクセス権を定めたうえでトレースや構造化ログに記録します。ID ごとにメトリクスの時系列を作ると、扱うデータ量が膨らみます。 OpenTelemetry の可観測性入門 · Prometheus のラベル設計
調査で分かったことを監視に戻す
既存のホスト監視は活かし、まず決済経路にトレースと構造化ログを追加できます。ダッシュボードを増やす前に、サービスや環境を表す項目をそろえます。調査後に必要になるのは、見つけた兆候の数だけ通知を増やすことではありません。既存アラートの条件を明確にする、対応手順へのリンクを添える、計測できていなかった依存先を補う、といった変更が次の対応に効きます。
時間がかかった工程も振り返ります。検知、引き継ぎ、調査、影響の軽減、復旧のどこで止まったかを見れば、アラート、計装、対応手順のどれを見直すべきか判断しやすくなります。
関連記事
