



技术指南
日志级别详解:FATAL 到 TRACE 的正确用法
日志级别(Log Level)用于标记日志事件的严重程度。本文详解 FATAL、ERROR、WARN、INFO、DEBUG、TRACE 六个级别的含义与典型场景,以及在观测云中如何用 status 字段实现按级别检索、着色与告警。
从概念、接入到生产治理,提供可执行、可验证的工程方法。
日志级别(Log Level)用于标记日志事件的严重程度。本文详解 FATAL、ERROR、WARN、INFO、DEBUG、TRACE 六个级别的含义与典型场景,以及在观测云中如何用 status 字段实现按级别检索、着色与告警。
生产排障常需临时开启 DEBUG 日志。本文介绍三种无需重启即可动态调整日志级别的方法:API 端点、UNIX 信号、配置文件热加载,并讲解如何在观测云侧配合控制采集量与成本。
微服务架构下日志分散在数十个服务中,排查问题如同大海捞针。本文分享五条核心实践——日志标准化、集中化、trace_id 关联、分布式追踪、安全防护,并给出基于观测云 DataKit、APM 与多索引的落地方案。
从日志目标、级别和结构化输出,到采样、留存、敏感数据防护与性能控制,整理十二条可直接落地的日志实践。
日志格式化决定了日志能否被高效检索与分析。本文讲解非结构化/半结构化/结构化三种日志格式的区别,以及九条生产环境日志格式化实践:JSON 输出、ISO-8601 时间戳、字符串级别、来源信息、版本号、堆栈跟踪、上下文字段规范、关联 ID 与对象字段控制。
从代码排除、脱敏、令牌化、传输加密和访问控制,到敏感数据扫描与 Pipeline 脱敏,建立纵深防护。

日志采样(Log Sampling)从符合条件的日志中保留一部分。通过 Go 示例比较随机采样、时间窗口限流与 trace ID 哈希,并说明必留日志和观测云过滤、索引的边界。
日志成本失控往往源于"什么都记、永久留存"。本文给出七步降本法:测算成本、削减日志量、采样、留存策略、错误日志限流、摄入量告警、平台重估,并结合观测云黑名单、多索引与数据转发给出落地操作。
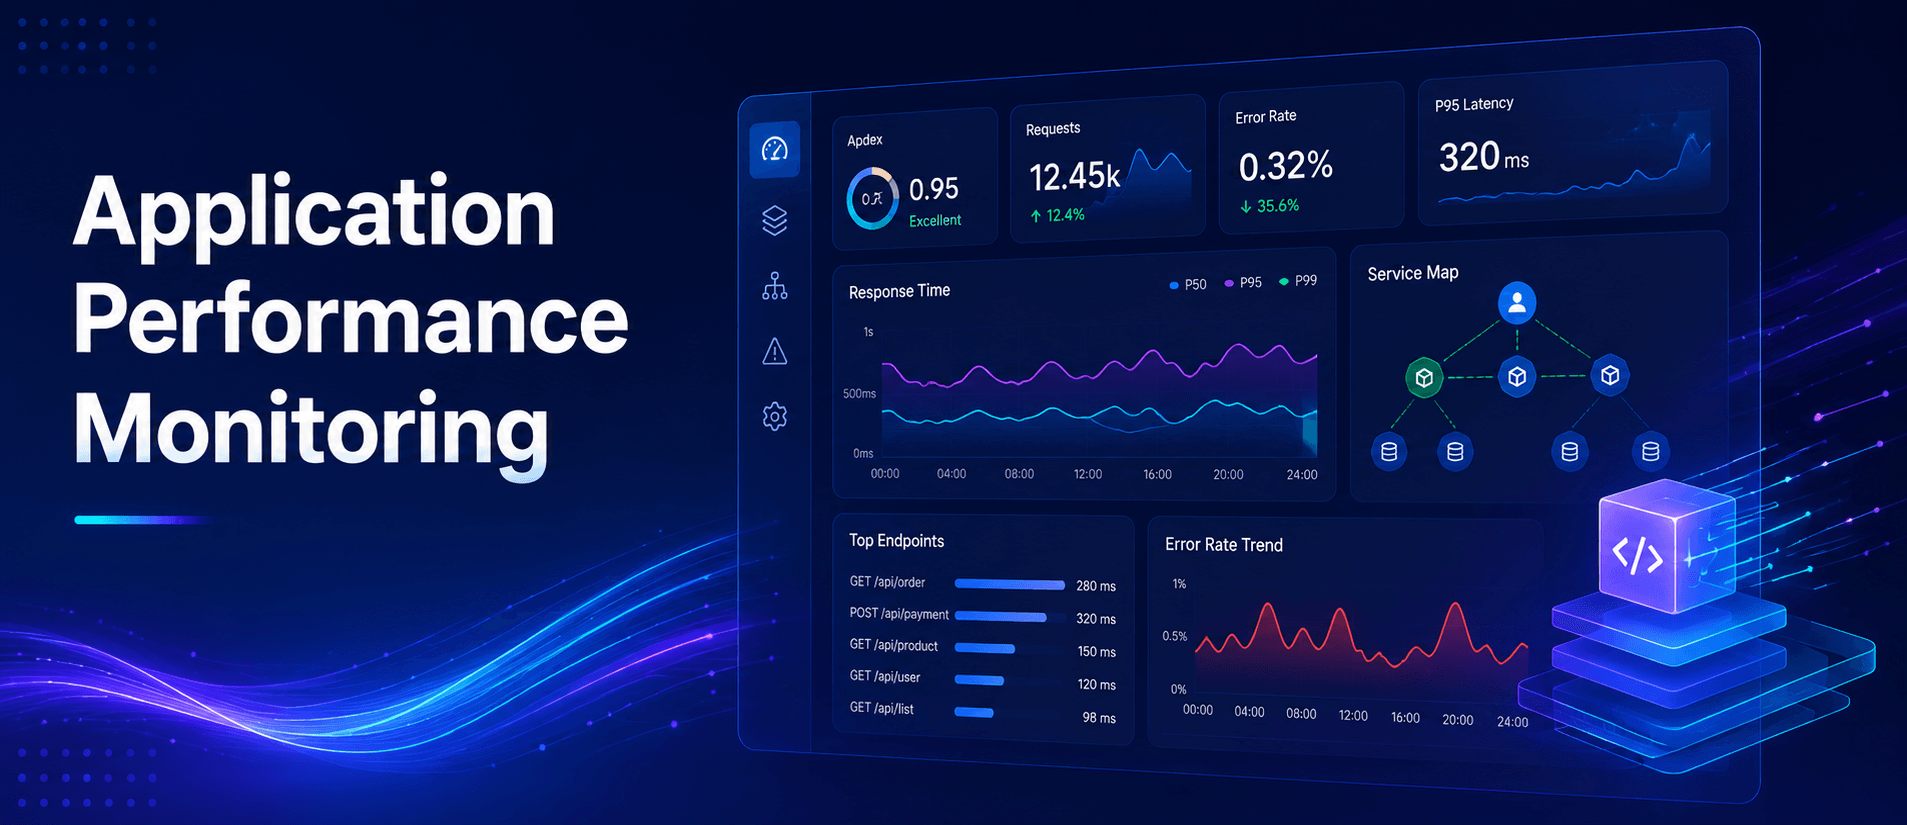
把真实用户访问、页面性能、错误和后端调用关联起来,让团队更快定位影响用户体验的性能瓶颈。

联动 AI Agent,打通代码生成到稳定运行,用脚本调度与运维管控帮助轻量能力快速交付落地。

把分散的日志集中检索、关联和分析,在海量数据中快速找到与故障、性能和安全事件有关的关键线索。

统一观察主机、容器与云资源的运行状态,让基础设施异常及其对应用和业务的影响更清晰。