AI 运维工具怎么选:告警关联、调查与执行边界
从告警分组、原始证据和执行权限,比较 BigPanda、PagerDuty、Splunk ITSI、Datadog Bits 与观测云的实际工作方式及运行成本。
如果告警已经能叫醒正确的人,我会先看他们接下来还在重复做什么。是几十条通知需要合并,是几个团队不知道由谁接手,还是工程师要反复查日志、链路和发布记录,才能解释同一次故障?这些工作都可能被叫作 AIOps,买到的却是不同产品。
企业选择 AI 运维工具,不必先把现有监控换掉。事件关联可以接在原有告警之后,调查能力也可能利用现有平台的数据。如果主要时间花在跨系统查证和维护关联入口上,就值得把统一可观测平台一起纳入比较。观测云在这里的价值,应落实到已有数据、调查入口和可授权的工具,而不是一个笼统的“AI 闭环”。
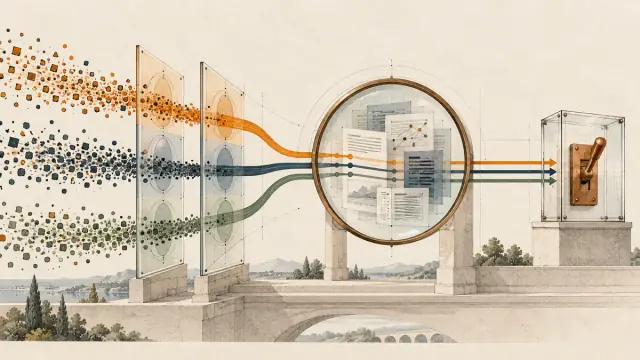
我会把判断拆成三件事:哪些通知可以合并,结论能回到哪些原始证据,以及谁有权执行下一步动作。把这三件事分清,AIOps 选型才不会把更少的通知误当成更可靠的恢复。
观测云编辑部 · 2026 年 10 月 28 日。本文按当前官方文档比较产品机制,观测云也是讨论对象。文中算例采用明确假设,未执行各平台的同负载对照测试。
先分清要减少哪一部分工作
传统监控已经能通过阈值、规则和其他分析发现异常。事件关联把相关告警组织成可处理的事件;调查进一步查询上下文、提出并核对原因;执行则会改变系统状态。它们可以共存,但交付一种能力,不代表同时交付了另外两种。
| 团队卡住的工作 | 值得先看的能力 | 仍要保留的依据 |
|---|---|---|
| 多个监控同时通知同一次故障 | 关联、分组和路由 | 原始告警、受影响对象、拆分与合并关系 |
| 知道哪里异常,却要来回查证 | 带数据与工具访问的调查 | 查询、时间窗口、原始记录与未证实的假设 |
| 结论已有,操作仍靠手工接力 | 工单、响应与执行编排 | 操作范围、权限、执行结果和恢复路径 |
| 每次调查都要重建跨系统链接 | 统一可观测数据与关联入口 | 采集完整性、业务标识、留存与访问控制 |
已有监控覆盖充分,主要问题是告警汇聚和接手,可以先比较 BigPanda、PagerDuty 或现有 Splunk ITSI 的相关能力。已经在 Datadog 内完成大部分调查,则应先看 Bits Investigation 的增量价值。缺少共同数据和调查路径时,观测云这类平台才是在更大范围内改变分工。
告警关联,先取决于字段和时间
两条通知的标题相似,不足以证明它们属于同一故障。不同环境可以有同名服务,同一资源也可能先后发生两次独立问题。关联至少要保留服务、环境、资源、来源与事件时间,再选择分组条件和时间范围。时间窗口太宽会合并独立故障,太窄则把同一问题拆散。
BigPanda 的关联模式使用来源、标签、时间窗口和可选过滤条件。官方文档将标准化与富化列为有效关联的前提;应用名、主机和依赖等信息,必须从监控或其他接入来源中取得。规则还要随命名和系统变化持续维护。这比只问“能压缩多少百分比”更接近实际工作。BigPanda 关联机制
Splunk ITSI 的对象是 notable event 与 episode。聚合策略的过滤、拆分字段和结束条件,决定哪些事件进入同一 episode;动作规则再按条件执行通知或外部操作。ITSI 5.0 可按策略优先级处理:命中高优先级策略后,不再按较低优先级重复建立 episode;同优先级的匹配策略仍可能产生多个 episode。因此原始事件数、episode 数和动作次数应分别计量。ITSI 的服务健康与事件管理,也不能直接等同于整个 Splunk Observability Cloud。ITSI 聚合策略
PagerDuty 的 Intelligent Alert Grouping 面向相关告警合并到事件,Event Orchestration 则处理规则、路由和可配置动作。目前的功能归属包含 AIOps 附加包,或 PD Reliability Platform 中的 Signal Intelligence;具体编排与自动化权益要按所选方案确认,不能把一个分组功能当作全部执行能力。告警分组 · Event Orchestration
降噪的数字也要留住分母。假设 1,000 次通知被整理成 200 次,同时这批数据里有 20 次已知、需要行动的故障,整理后只剩 18 次仍能独立发现并处理:
通知减少比例 = (1,000 − 200) ÷ 1,000 = 80%
已知可行动故障保留比例 = 18 ÷ 20 = 90%
这是人为设定的例子,说明两个指标可以同时出现。80% 的通知减少,不能独自证明治理成功;另外两次故障可能被错误合并或抑制。回看历史告警时,要保留它们与已知故障的对应关系,而不只统计整理后的总量。
调查的质量,取决于实际能读到什么
事件摘要提供起点,细粒度调查还需要原始数据。错误率上升时,日志能说明报错,链路能定位请求依赖,发布记录能说明变化,RUM 则可能揭示用户影响。某个信号没有采集、已经过期或当前身份无权读取,解释就有相应缺口。
观测云可在工作空间页面向 Agent 派发任务,并带入当前上下文。这个入口能减少重新描述服务、时间和筛选条件的工作,但官方文档也明确:附加上下文不会扩大成员或 Agent 的数据权限,更不表示已经取得全部关联数据。日志与链路仍需一致标识,相关信号也须已经采集并保留。在工作空间使用 Agent
Obsy Copilot 适合在当前视图理解数据和生成查询;Agent Teams 则可以按任务调用已配置工具。Skill 提供知识、步骤与输出约定,MCP 提供外部数据或操作入口;工具是否可用,继续受目标账户、数据范围和 Agent 权限模式约束。接入 OWL 或其他 MCP 服务,解决的是访问路径,不能据此断言根因已经成立。Obsy Copilot · Skill 与 MCP 的分工
Datadog 当前使用 Bits Investigation 这一名称。它能从受支持的监控器或其他入口开始调查,形成假设后继续查询证据;资料不足时也可以给出未定结论。当前文档还列出了 Grafana、Dynatrace、Splunk、ServiceNow 等第三方数据集成,并标为 Preview。因此,既不能说它只能读取 Datadog 数据,也不能把预览连接当作所有客户都已配置好的生产能力。Bits Investigation 的来源与调查过程
Splunk 的产品边界同样影响证据路径。Log Observer Connect 可从 Observability Cloud 查询 Splunk Enterprise 或 Splunk Cloud Platform 中的日志;该连接本身不保存或索引日志,原平台仍承担日志存储和搜索。界面里能看到日志,与买入了相同留存和查询资源,是两件事。Log Observer Connect
已有 New Relic 与 ServiceNow 部署,也有延续现状的调查路径。New Relic 的 Issue Impact 位于 Response Intelligence 的“What's impacted?”;Issue Insights 则通过 New Relic AI outbound 与 ServiceNow Now Assist 的集成调用。两者入口不同,应按实际启用的组件和权限比较调查步骤,不能把工具清单当成所有 AI 面板的默认能力。New Relic AI 工具与入口
拓扑和依赖模型也有价值,例如 Dynatrace Intelligence 使用相关上下文支持分析。模型是否包含出问题的组件、变更与依赖,仍会影响结论。不能只凭“因果 AI”或“多 Agent”名称推导准确率高低。Dynatrace Intelligence
从调查到执行,多了一套权限与结果判断
读日志与修改部署所需的权限不同。即使结论合理,重启一个无状态副本、操作数据库主节点和回滚带数据迁移的版本,也有不同前置条件。审批应针对准备执行的动作、目标和影响范围;执行后的健康检查还要判断业务是否恢复。
Bits 当前将代码修复、响应协作和基础设施动作分开。代码修复通过 Bits Code 与源码系统协作,产出供审阅的更改;Kubernetes 的 one-click actions 与 Bits Guardrails 仍标为 Preview。前者需要能访问集群的 Private Action Runner 及相应权限,Guardrails 则提供按动作和范围设置 Ask 或 Deny 的控制。不能把“已生成修复建议”写成“已自动修复生产”。Bits Remediation
观测云 Agent Teams 的任务同样受权限模式、工具和账户授权约束;高风险动作可能出现审批请求。应检查任务实际引用了什么、准备调用哪个工具以及结果如何确认。停止执行只中断当前进行的响应或操作,不会自动撤销此前已经完成的外部更改。任务、审批与停止
一套有用的验证可以很具体:给同一动作分别使用允许和拒绝的身份,观察是否真的受限;在重复提交前检查目标系统状态,避免因连接中断而执行两次;最后把操作结果与业务健康信号放在一起看。这里验证的是权限和状态变化,不是让模型解释自己的答案有多可信。
数据边界和反馈,要沿调用路径看
私有化部署不等于所有数据都不外发。采集、存储、模型推理、MCP 工具和支持访问可能位于不同位置;自定义模型也需要按实际端点与数据处理约定判断。观测云提供部署版,但模型和外部工具的调用仍应逐条追踪。部署方式、工作空间权限与推理路径,应一起决定数据放在哪里。观测云部署方式
修正一次错误结论,也不一定要训练模型。字段指错了服务,就改字段;查错时间范围,就改查询;漏掉依赖,就补充数据;处理步骤过时,就更新 runbook 或 Skill。把这些具体更改保留下来,才能看出下次调查为什么不同。不存在所有平台都需要训练两个季度,或没有重训就会半年退化的统一规律。
已有 Prometheus、Zabbix 或自建分析流程的团队,也可以围绕这些接口继续建设。保留控制权的同时,要有人维护数据约定、查询、模型调用、权限和故障恢复。即便选用无需购买许可证的开源组件,这套服务仍有推理、基础设施与持续支持投入。
旧产品名称应回到当前服务范围。检索 Moogsoft 时,会遇到 Dell 接续的服务与历史名称;Dell 当前法律资料列出 APEX AIOps Incident Management 的服务说明。它与同一品牌下的应用可观测服务不能混作一项采购,也不能用旧 Moogsoft 资料推定新合同的连接器和部署条件。Dell 当前服务说明
费用应随着真正减少的工作一起比较
AI 调查、告警接收、工作流执行和底层遥测可能分别计量。PagerDuty AIOps 文档使用事件消耗口径;Datadog 的 AI 产品则应核对当前 AI Credits 与具体调查、代码或其他能力的消耗规则。观测云也要把遥测、留存、Agent 方案和实际工具调用放进同一个范围,不能用旧套餐的起步价代表总费用。PagerDuty AIOps · Datadog 当前定价 · 观测云 Agent 方案
用量应按真实触发方式计算。例如 Bits 的自动调查在受支持监控器进入 alert 状态时发起,warn、no data、重复通知和测试通知并不触发这项自动调查。把通知次数直接乘以调查单价,会把不同单位混在一起。还需考虑同一故障引发多少监控器转为 alert,以及调查和人工查询是否同时消耗资源。自动调查触发条件
我会保留通知量、漏掉的可行动故障、人工调查时间和恢复时间,明确每个时间指标的起止点,再看相似故障是否改善。产品账单、客户侧资源、实施与持续维护一起比较,工程时间与现金支出分列。供应商案例中的降噪或 MTTR 百分比,可以说明某个案例的结果,不能替代自己的分母与成本基线。
监控底座已经可靠,问题主要在事件汇聚与响应,就先改善这一层;数据已经集中在现有平台,则先看它的调查能力。 跨系统查证与维护长期占用工程时间时,我更倾向把观测云作为数据、调查入口和可授权工具的整体服务来比较。迁移的价值,应出现在可以停止的重复工作,以及仍能保留的证据与行动能力中。