可观测性 vs 监控:一字之差,区别到底在哪
监控(Monitoring)与可观测性(Observability)经常被混用,但两者解决的问题不同:监控发现已知模式的异常,可观测性支持对未知问题的探索。本文系统对比两者的定义、要素与适用场景,并说明现代平台如何把二者统一起来。
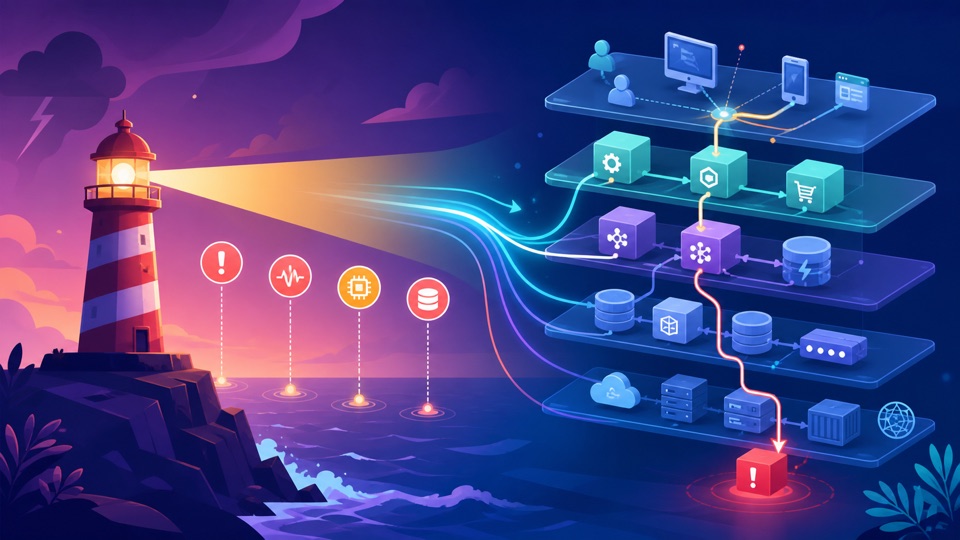
监控是预设规则、持续检查系统是否处于已知异常状态的实践;可观测性是系统的一种属性,指通过外部输出推断内部状态、回答任意问题的能力——监控回答「是不是出事了」,可观测性还要回答「为什么出事、从哪里开始坏的」。两者不是替代关系,而是现代可靠性工程的一体两面。
核心要点速览
- 监控面向「已知的未知」(known unknowns):你预设的故障模式;
- 可观测性面向「未知的未知」(公开资料未说明 unknowns):从未发生过的问题;
- 监控的核心要素:指标采集、阈值告警、仪表板;可观测性还要求高基数数据、关联分析与自由探查能力;
- 落地建议:用监控守住 SLO 底线,用可观测性能力压缩排障时间。
什么是监控?
监控的经典定义是:按照预先设定的规则采集数据,当数据偏离预期时通知你。它包含三个要素:
- 采集:定期获取系统状态(指标为主);
- 判断:阈值、同比环比、无数据等规则;
- 通知:把人叫起来处理问题。
常见监控类型:基础设施监控(主机/容器资源)、应用监控(接口成功率)、可用性监控(拨测)、业务监控(订单量)。
监控的前提是你已经知道系统可能怎么坏。CPU 会满、磁盘会满、接口会超时——这些都是历史经验沉淀下来的故障模式。
什么是可观测性?
可观测性是系统本身具备的一种属性:当从未见过的问题发生时,你依然能通过系统输出的日志、指标、链路等数据,定位到根因而无需重新部署、无需加打印。
它的关键要素:
- 高维度数据:标签基数足够高,能按用户、按实例、按版本任意切片;
- 信号关联:指标异常能下钻到链路和日志;
- 自由探查:支持即席查询,而不是只能看预先做好的图。
实践中两者如何配合?
一个典型的故障处理时间线:
- 监控触发:「订单接口错误率超过 2%」的阈值告警发出(监控的价值:及时发现);
- 可观测性介入:沿着告警关联数据下钻——错误集中在哪个服务、哪个版本、哪个下游依赖(可观测性的价值:快速定位);
- 根因确认:读取该请求的链路详情与日志,确认是一次发布引入的 bug;
- 反哺监控:把这次新发现的故障模式固化为新的告警规则。
监控决定 MTTD(平均发现时间),可观测性决定 MTTR 中的定位环节。
两者的常见挑战
- 监控的挑战:规则维护成本高、告警风暴、阈值拍脑袋;
- 可观测性的挑战:数据量成本、埋点覆盖率、团队使用习惯。
两者的共同解法都是平台化:统一数据模型、统一标签体系、统一告警通道,避免每个团队各自为战。
观测云落地:监控与可观测性的统一平台
观测云把两者融合在一个数据底座上:
- 监控侧:监控器支持阈值、突变、区间、无数据、离群等多种检测方式,覆盖指标、日志、链路、RUM 等全部数据源;告警策略对接钉钉/企微/飞书;
- 可观测性侧:查看器支持 DQL 即席查询与多维过滤,指标-日志-链路通过标签和 trace_id 互相关联,仪表板与查看器双向跳转;
- 从告警到下钻:事件详情直接展示关联数据,一键跳到对应时间窗的日志查看器与链路追踪,把「发现」和「定位」连成一条线。
常见问题(FAQ)
Q:是不是有了可观测性就不需要监控了? 恰恰相反:可观测性能力越强,越需要监控来主动触发告警,否则数据躺在那里没人看。两者是互补关系。
Q:传统监控工具(Zabbix 类)能升级到可观测性吗? 可以渐进演进:先把 Zabbix 数据接入观测云统一告警,再逐步为应用补充链路与结构化日志,最后实现信号关联。
Q:可观测性平台的「探查」具体指什么? 指不依赖预置仪表板,临场用查询语言(如 DQL)对原始数据做任意维度的过滤、分组、聚合,回答突发问题。
Q:SLO 属于监控还是可观测性? SLO 的定义基于监控数据(SLI),但 SLO 不达标后的根因分析依赖可观测性能力。观测云的监控器可直接配置 SLO 目标并生成燃烧率视图。
系列阅读
- 上一篇:《什么是可观测性》
- 下一篇:《什么是 APM》
- 相关:《日志、指标、链路的区别与联系》 · 《返回索引》
