技术指南
Java 应用接入 Prometheus 监控(Spring Boot 实战)
Spring Boot 接入 Prometheus:Micrometer + Actuator 暴露 /actuator/prometheus、JVM 默认指标解读、Counter/Gauge/Timer 自定义埋点与生产配置要点。
从概念、接入到生产治理,提供可执行、可验证的工程方法。
Spring Boot 接入 Prometheus:Micrometer + Actuator 暴露 /actuator/prometheus、JVM 默认指标解读、Counter/Gauge/Timer 自定义埋点与生产配置要点。
Rails 应用接入 Prometheus:prometheus-client gem、Rack 中间件暴露 /metrics、Counter/Gauge/Histogram 埋点、Puma 多进程模式的数据聚合问题与解决方案。
Helm 部署 Prometheus 到 K8s 全流程:添加仓库、安装 chart、values 定制(持久化、保留期、资源)、kube-prometheus-stack 全家桶方案与生产注意事项。
Helm 部署 Grafana 到 K8s:grafana chart 安装、持久化配置、数据源与仪表盘的 provisioning、Ingress 暴露与安全注意事项。
Lambda 核心指标详解:调用量、错误、并发、Duration 与冷启动 Init Duration、内存利用率、节流与迭代器延迟;每个指标的含义、告警建议与优化方向。
告警疲劳是团队被无效告警轰炸到麻木的组织病。识别五类噪声告警(误报/不可行动/重复/过时/配置烂),治理手段:时间容忍、静默、分组、路由与定期审计。
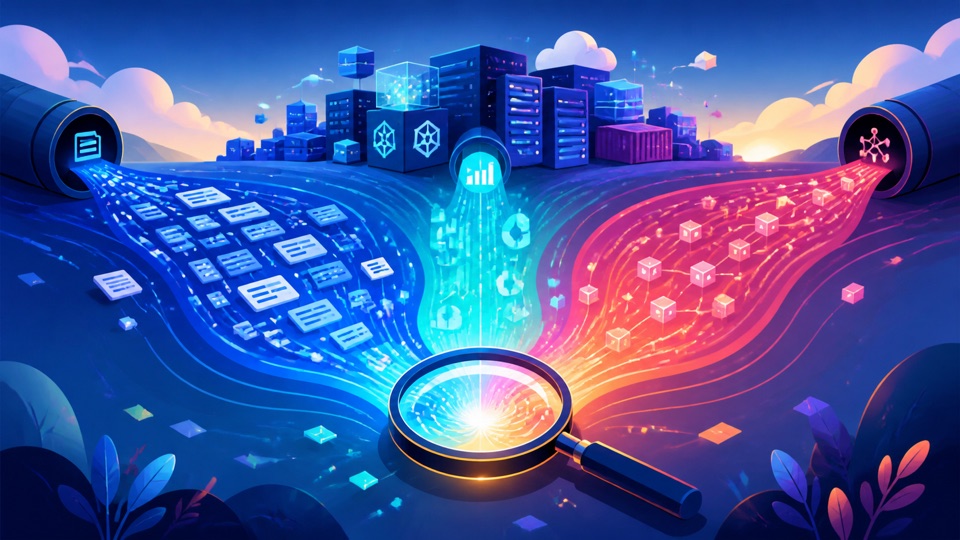
日志(Logs)、指标(Metrics)、链路追踪(Traces)被称为可观测性三大支柱,但三者的区别与适用场景常被混淆。本文用通俗的方式讲清每种信号的定义、优势与局限,以及如何借助观测云把三者关联成一个完整的排障闭环。
日志记录系统运行的一切事件,错误追踪则专门捕获、聚合和告警应用异常。本文讲清日志与错误追踪(Error Tracking)的核心区别、各自适用场景,以及在观测云中如何把两者结合起来构建完整的异常发现机制。
可观测性是通过系统外部输出(日志、指标、链路)理解内部状态的能力。本文从概念起源讲起,拆解可观测性的四大信号、实施路径与常见挑战,并给出基于观测云平台的落地建议。
监控(Monitoring)与可观测性(Observability)经常被混用,但两者解决的问题不同:监控发现已知模式的异常,可观测性支持对未知问题的探索。本文系统对比两者的定义、要素与适用场景,并说明现代平台如何把二者统一起来。
APM(Application Performance Monitoring,应用性能监控)通过埋点采集应用的响应时间、吞吐量、错误率与调用链路,帮助团队保障用户体验。
分布式追踪通过 Trace 与 Span 记录请求在微服务间的完整流转路径,是微服务排障的核心技术。本文讲透 Trace ID、Span、埋点、上下文传播、采样等核心概念,以及如何用观测云落地分布式追踪。