治理噪声告警,防止告警疲劳
告警疲劳是团队被无效告警轰炸到麻木的组织病。识别五类噪声告警(误报/不可行动/重复/过时/配置烂),治理手段:时间容忍、静默、分组、路由与定期审计。
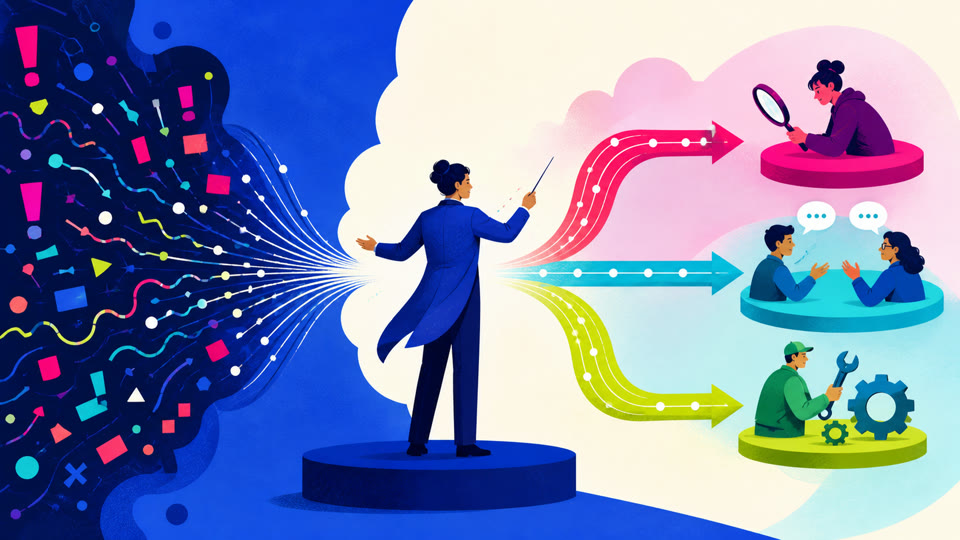
告警疲劳是这样发生的:告警太多 → 大量是噪声 → 值班人开始忽略 → 某天忽略了真的那条 → 事故。治理噪声告警不是"优化项",是监控系统能否长期可信的生死线。
先识别:五类噪声告警
- 误报(False positives):瞬时尖刺触发的告警,比如批任务启动时 CPU 冲高一秒。系统其实没问题。
- 不可行动(Non-actionable):告警了但什么都不用做——"每天 2 点备份开始"不需要告警任何人。
- 重复(Duplicates):一个根因引发一串告警——数据库挂了,20 个依赖它的服务各自报警。
- 过时(Outdated):服务都下线了,它的告警规则还在。
- 配置粗糙(Poorly configured):阈值拍脑袋、没有分级、所有告警都打电话。
统计方法:拉出过去 30 天的告警记录,逐条标注"这条告警是否导致了人的有效行动"。行动率低于 50% 的告警规则就该修或删。
治理手段一:给告警加时间容忍
瞬时波动不该触发告警。for 子句要求条件持续成立才触发:
alert: HighCPU
expr: cpu_usage > 90
for: 10m          # 持续 10 分钟才告警,针刺被过滤
治理手段二:维护窗口静默
发布、扩容、数据迁移期间已知会产生告警——提前静默,别训练团队"这个时段的告警可以忽略":
amtool silence add alertname=~"DeployRelated.*" --duration=2h --comment="版本发布"
治理手段三:分组与抑制
- 分组:
group_by把同一事件的告警聚成一条通知; - 抑制:根因告警存在时,压掉下游衍生告警(详见 Alertmanager 一篇)。
20 条告警变 1 条,值班人看到的从"噪声海"变成"事件"。
治理手段四:路由与分级
- 对的人收对的告警:数据库告警给 DBA,别全员广播;
- 分级通道:P1(需要立即行动)→ 电话;P2(工作时间处理)→ IM;P3(知会)→ 邮件/工单。不是所有异常都配得上打断睡眠;
- 值班轮换:告警压力集中在一个人身上,疲劳是必然的。
治理手段五:定期审计告警规则
每季度过一次告警清单:每条规则回答三个问题——它上次触发是什么时候?触发后有人行动吗?行动手册在哪?答不上来的规则,删掉或降级。
观测云对照
观测云监控器内置防噪声设计:检测条件支持"持续 N 分钟/连续 N 次"(时间容忍开箱即用)、告警策略支持分组聚合与分级通知(钉钉/企微/飞书/电话)、免打扰时段覆盖维护窗口;告警历史与处理状态留痕,季度审计直接从告警记录里拉数据——哪些规则从没产生过有效行动,一目了然。
常见问题(FAQ)
Q:删了告警规则怕漏报怎么办?
A:先降级(电话→IM→邮件)观察一个月,再决定删不删。告警的价值要用历史数据验证,不靠想象。
Q:团队已经"习惯性忽略"了,怎么重建信任?
A:承认现状,公开治理:公布"告警行动率"指标,每周公示治理进展;每删掉一条噪声规则都广而告之。信任靠一次次"告警了 = 真的有事"重建。
Q:新服务上线时怎么配告警才不吵?
A:先只配"面向用户的症状告警"(错误率、延迟、可用性),资源类告警观察两周基线后再定阈值。新服务前两周告警多是正常的,别因此把告警全静音。
