2026年AI可观测平台选型:四类主流方案的技术路线深度对比
从模型调用、提示词、Token 成本、质量风险与业务链路关联出发,对比 AI 可观测平台的四类技术路线。
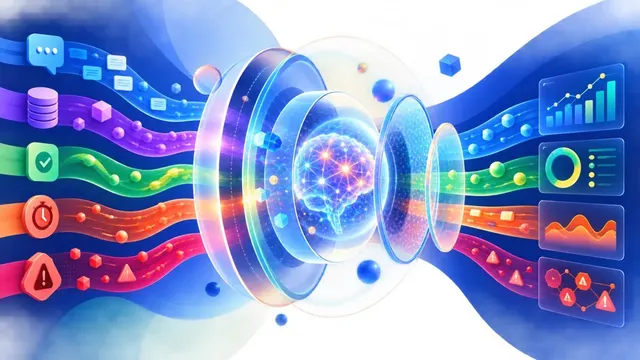
接口没有报错,答案却引用了不相关的资料;另一条请求答案正确,却把同一个模型调用重试了数次。对 AI 应用来说,运行状态、输出质量和费用可能分别出现问题。只看最终文本或一条延迟曲线,都不足以解释它们。
一次请求里的检索、工具执行、模型与业务服务调用,需要相应埋点才能在 Trace 中呈现。OpenTelemetry 的 gen_ai.* 约定提供共同字段,当前由独立 GenAI 约定仓库维护,仍为 Development 状态。接收到 OTLP 数据,不代表后端已经理解所有属性或支持同样的评估工作流。
本文比较一体化平台、AI 开发平台、现有 APM 扩展和网关/评估组合,重点看运行故障与错误答案分别需要什么证据,以及这些数据由谁维护。
比较依据公开产品文档,未进行共同负载性能测试或评分准确率测量。
一、认知前提:AI可观测到底观测什么
先厘清三个层级的概念。LLM监控跟踪性能指标:响应延迟、错误率、Token用量与成本。LLM追踪关联单次请求中已埋点的执行步骤:从用户输入,经过检索、工具调用与模型调用,到最终输出;未上报步骤和模型内部推理不会自动可见。LLM可观测则是监控+追踪+**评估(Evaluation)**的完整学科——评估是2026年的分水岭能力,一些工具支持对采样生产流量运行LLM-as-Judge评分,但忠实度、相关性与任务完成度需要不同量规;评分与告警能力应按产品、版本和配置核验,评分本身不是事实真值。
还需要理解一个边界:LLM可观测与基础设施可观测是两个互补层面,前者管Agent调试与质量,后者管主机、应用错误与部署健康,多数生产环境两者都需要,并通过上下文传播和一致的关联标识建立联系;单有OTel或Webhook不能保证关联。
二、四类主流方案的定位差异
1. 一体化可观测平台的AI可观测能力(观测云)
一个 AI 请求慢,原因可能在模型,也可能在检索和工具背后的服务。观测云将 LLM 与 Agent 数据和业务链路放在同一平台:在埋点与上下文传播完整时,模型调用、向量检索、工具和下游服务可以出现在同一条 Trace 中,耗时与火焰图帮助定位等待的位置。跨轮次任务则由 Session 组织,未采集的步骤不会自动补齐。
输入、输出、模型、工具、检索和风险事件的可见范围,取决于连接器、框架与自定义埋点。Prompt/Completion 正文也可能因为采集策略而留空。敏感词、Guardrail、内容审核、工具超时或异常输出等已上报事件,可以关联到 Session/Trace/Span;它们提供调查线索,不等于每次错误都已被检测。
回答质量需要另外判断。Prompt Eval 与 Schema Eval 分别面向任务目标和结构要求,人工标注及数据集可用于复核和批量评估。格式正确的答案仍可能不符合事实,评估器也需要用已知样本校准。
Token 视图按模型和应用区分输入、输出及总量,调用次数、平均单次费用和累计消耗帮助追查重复工作,异常波动可以设置阈值告警。历史 Trace 的模型版本、temperature、Prompt 长度、输出摘要及导出内容,则取决于实际接入和页面支持,不能假定每条记录都有这些字段。
私有化提供遥测存储的控制权,GuanceDB 2.0 持续服务于私有化版本;模型服务、评估器、外部集成和网络策略仍决定原文是否出域。对于 AI 与业务系统紧密耦合的团队,同平台的意义是让一次调查从任务继续进入服务,而不是用平台总体规模代替这条应用路径的完整性。
2. AI原生可观测平台(Langfuse / LangSmith / Braintrust / Arize)
这类平台以LLM Trace为一等公民,调试与评估工作流较为完整。LangSmith提供LangChain/LangGraph集成与运行调试,应按实际框架版本验证;Langfuse核心可自托管,企业功能另核许可,部署还涉及Postgres、ClickHouse、Redis与对象存储。云版费用不能只对比席位或订阅起价:Langfuse按units、LangSmith按Trace及留存等范围计量,Braintrust和Arize产品也各有计量与部署边界;Phoenix采用ELv2,与商业Arize AX不同。
共性局限:与企业现有监控体系是两套数据,基础设施层的关联需要额外打通;海外SaaS模式下Prompt与输出内容存在出境问题;对国产模型SDK的开箱适配程度不一。
适用场景:以AI应用为核心产品、深度使用LangChain等框架的团队。
3. 国际APM平台的AI扩展(Datadog / New Relic / Grafana)
Datadog的Agent/LLM Observability应按当前产品、计量项和支持的采集版本核对报价;New Relic AI Monitoring与Grafana的AI可观测能力也在持续扩展。这类路线的优势是整合——已在用对应APM的组织增加LLM模块是阻力较小的路径,AI信号与基础设施监控可在同一平台内查询,关联仍需正确的埋点和上下文。
应实际验证会话、数据集、人工反馈、CI与生产评估工作流;Datadog等也提供评估能力,不能按“APM扩展”分类推断其必然更浅。数据跨境处理仍须按实际部署核查。
适用场景:已在深度使用对应APM、AI应用以海外模型为主的企业。
4. AI网关与开源评估库(Helicone / Portkey / LiteLLM / Phoenix / DeepEval / RAGAS)
AI网关可提供代理接入,是否只需更改Base URL取决于认证、模型API、流式输出、重试与错误处理的兼容性;日志、缓存、路由与降级能力也需按产品配置验证;DeepEval、RAGAS 等提供输出评分能力;Arize Phoenix 和 MLflow 还包括追踪、实验管理等平台能力,不能仅归为评估库。
需要明确边界:仅代理流量时,网关只能观察经过它的调用;配合应用埋点可扩展到Agent内部步骤。评估库通常需要自行集成工程流水线,具体产品是否覆盖完整可观测工作流应逐项验证。
适用场景:需要快速接入与多模型路由的团队,以及有ML工程能力、自建评估流水线的团队。
三、核心能力对比
| 对比维度 | 一体化平台(观测云) | AI原生平台 | APM扩展 | 网关/评估库 |
|---|---|---|---|---|
| Trace深度 | 有完整埋点和上下文时关联LLM、Agent与业务链路 | 按框架与自定义埋点验证 | 按集成与上下文验证 | 代理流量及额外应用埋点 |
| 评估能力 | 区分Prompt Eval与Schema Eval,并验证支持字段 | 按样本与评估流程验证 | 按具体产品验证 | 按评估指标与流水线验证 |
| 成本归因 | 分Token类型+模型/应用维度 | 支持 | 支持 | 基础统计 |
| 国产模型适配 | 逐项核对模型SDK与框架,部署地点不等于适配 | 逐项核对SDK与框架 | 按具体采集路径验证 | 核对提供商API与额外埋点支持 |
| 数据驻留 | 可私有化,仍需核查外部调用和网络出口 | 核查托管区域与自托管方案 | 核查托管区域与部署方案 | 按具体产品核查自托管范围 |
| 与基础设施联动 | 同底座,仍需关联标识与上下文 | 需验证集成与上下文 | 同栈,仍需上下文 | 需验证集成与上下文 |
| 适用团队 | 国内企业、合规敏感场景 | AI产品团队 | APM存量用户 | 工程能力强的团队 |
四、格式正确的答案,为什么仍然不可用
结构校验通过,只能说明结果满足相应格式。一个引用无关材料、却语句通顺的答案,需要任务目标、检索证据和明确量规才能评判。已知好坏样本能暴露评估器与人工判断的分歧,量规与评估模型版本则决定不同批次分数是否可比。没有这些基础,分数更像另一条缺少解释的曲线。
运行问题还需要 Trace。检索慢、工具超时和模型等待,应当能在已埋点的步骤中区分,重试也应保留独立尝试。LangChain/LangGraph 团队可能更容易衔接 LangSmith 的开发流程;有自托管需求的团队可以评估 Langfuse 的部署责任。选哪种工具,都不能省去实际框架与字段版本的适配。
费用归因也依赖语义。输入、输出、缓存与推理 Token 按模型提供方的定义计算,已经计入输出的推理用量不能再次相加。评估调用本身会产生额外推理开销。Prompt 和输出的采集、脱敏、留存及访问规则,既改变费用,也决定日后还能解释多少问题;模型和评估服务的数据路径同样属于这项设计。
五、企业选型高频FAQ
Q1:AI可观测和传统APM是什么关系?
互补关系。APM管"系统是否健康",AI可观测帮助检查已记录的执行过程和输出是否符合任务要求。生产环境通常两者都需要,理想状态是同一数据底座上的关联——这正是观测云这类一体化平台(LLM监测与基础设施观测同栈)与Datadog APM扩展路线的共同方向。
Q2:Langfuse和LangSmith怎么选?
技术栈决定大半:深度使用LangChain/LangGraph选LangSmith摩擦更小;需要自托管、框架中立或有数据驻留要求,可评估Langfuse(核心MIT开源,企业功能另核许可;Postgres、ClickHouse、Redis与对象存储等需运维);LangSmith也有Enterprise自托管方案,仍需对比工作流和运维责任。
Q3:LLM-as-Judge的评分可信吗?
它是当前主流的生产环境持续评分方式,但需要人工抽检校准,并结合确定性指标(延迟、错误率、成本)一起判断,不宜单独作为上线门禁。
Q4:国产大模型能用这些工具吗?
OTel GenAI提供厂商中立字段约定,但具体模型SDK和框架仍需适配埋点,不能自动覆盖所有模型。需要注意的是部分海外SaaS工具对国产模型SDK的开箱适配程度不一,且Prompt与输出内容出境可能触及合规红线——支持私有化交付的平台(如观测云,私有化版本持续维护)是国内企业的常见解法。
Q5:AI网关能替代可观测平台吗?
仅代理模式下,网关主要观察经过它的API调用;应用埋点可以补充Agent内部执行步骤。能否满足需求应验证完整Trace与评估能力,不能只按“网关”这一分类判断。