基于观测云的 JMeter 压测报告与 APM 关联实践
本文介绍如何通过观测云关联 JMeter 压测数据与 APM 调用链路,统一分析性能指标,快速定位系统瓶颈,提升性能优化与故障排查效率。
背景与目标
压测结束后,JMeter 报告能够给出请求量、错误率和响应时间,但当某个接口的 P95 升高时,单靠报告往往难以判断耗时发生在应用处理还是数据库调用。测试人员掌握压测批次,开发人员查看调用链路;如果缺少统一的关联标识,两边的数据就很难对应到同一次测试。
本文面向使用 JMeter 开展接口压测的测试、开发与运维团队,介绍如何将完整 JTL 转换为报告指标,经 DataKit 接入观测云,并用统一批次标识关联 APM 数据。在一个 Dashboard 中,先查看报告结果,再定位到该批次中已采集的入口与数据库调用,为性能复盘提供可追溯的分析依据。
方案概览
完整 JTL 是请求数和响应时间的统计依据;APM 用于分析具体调用,不用采样链路数反推请求总量。
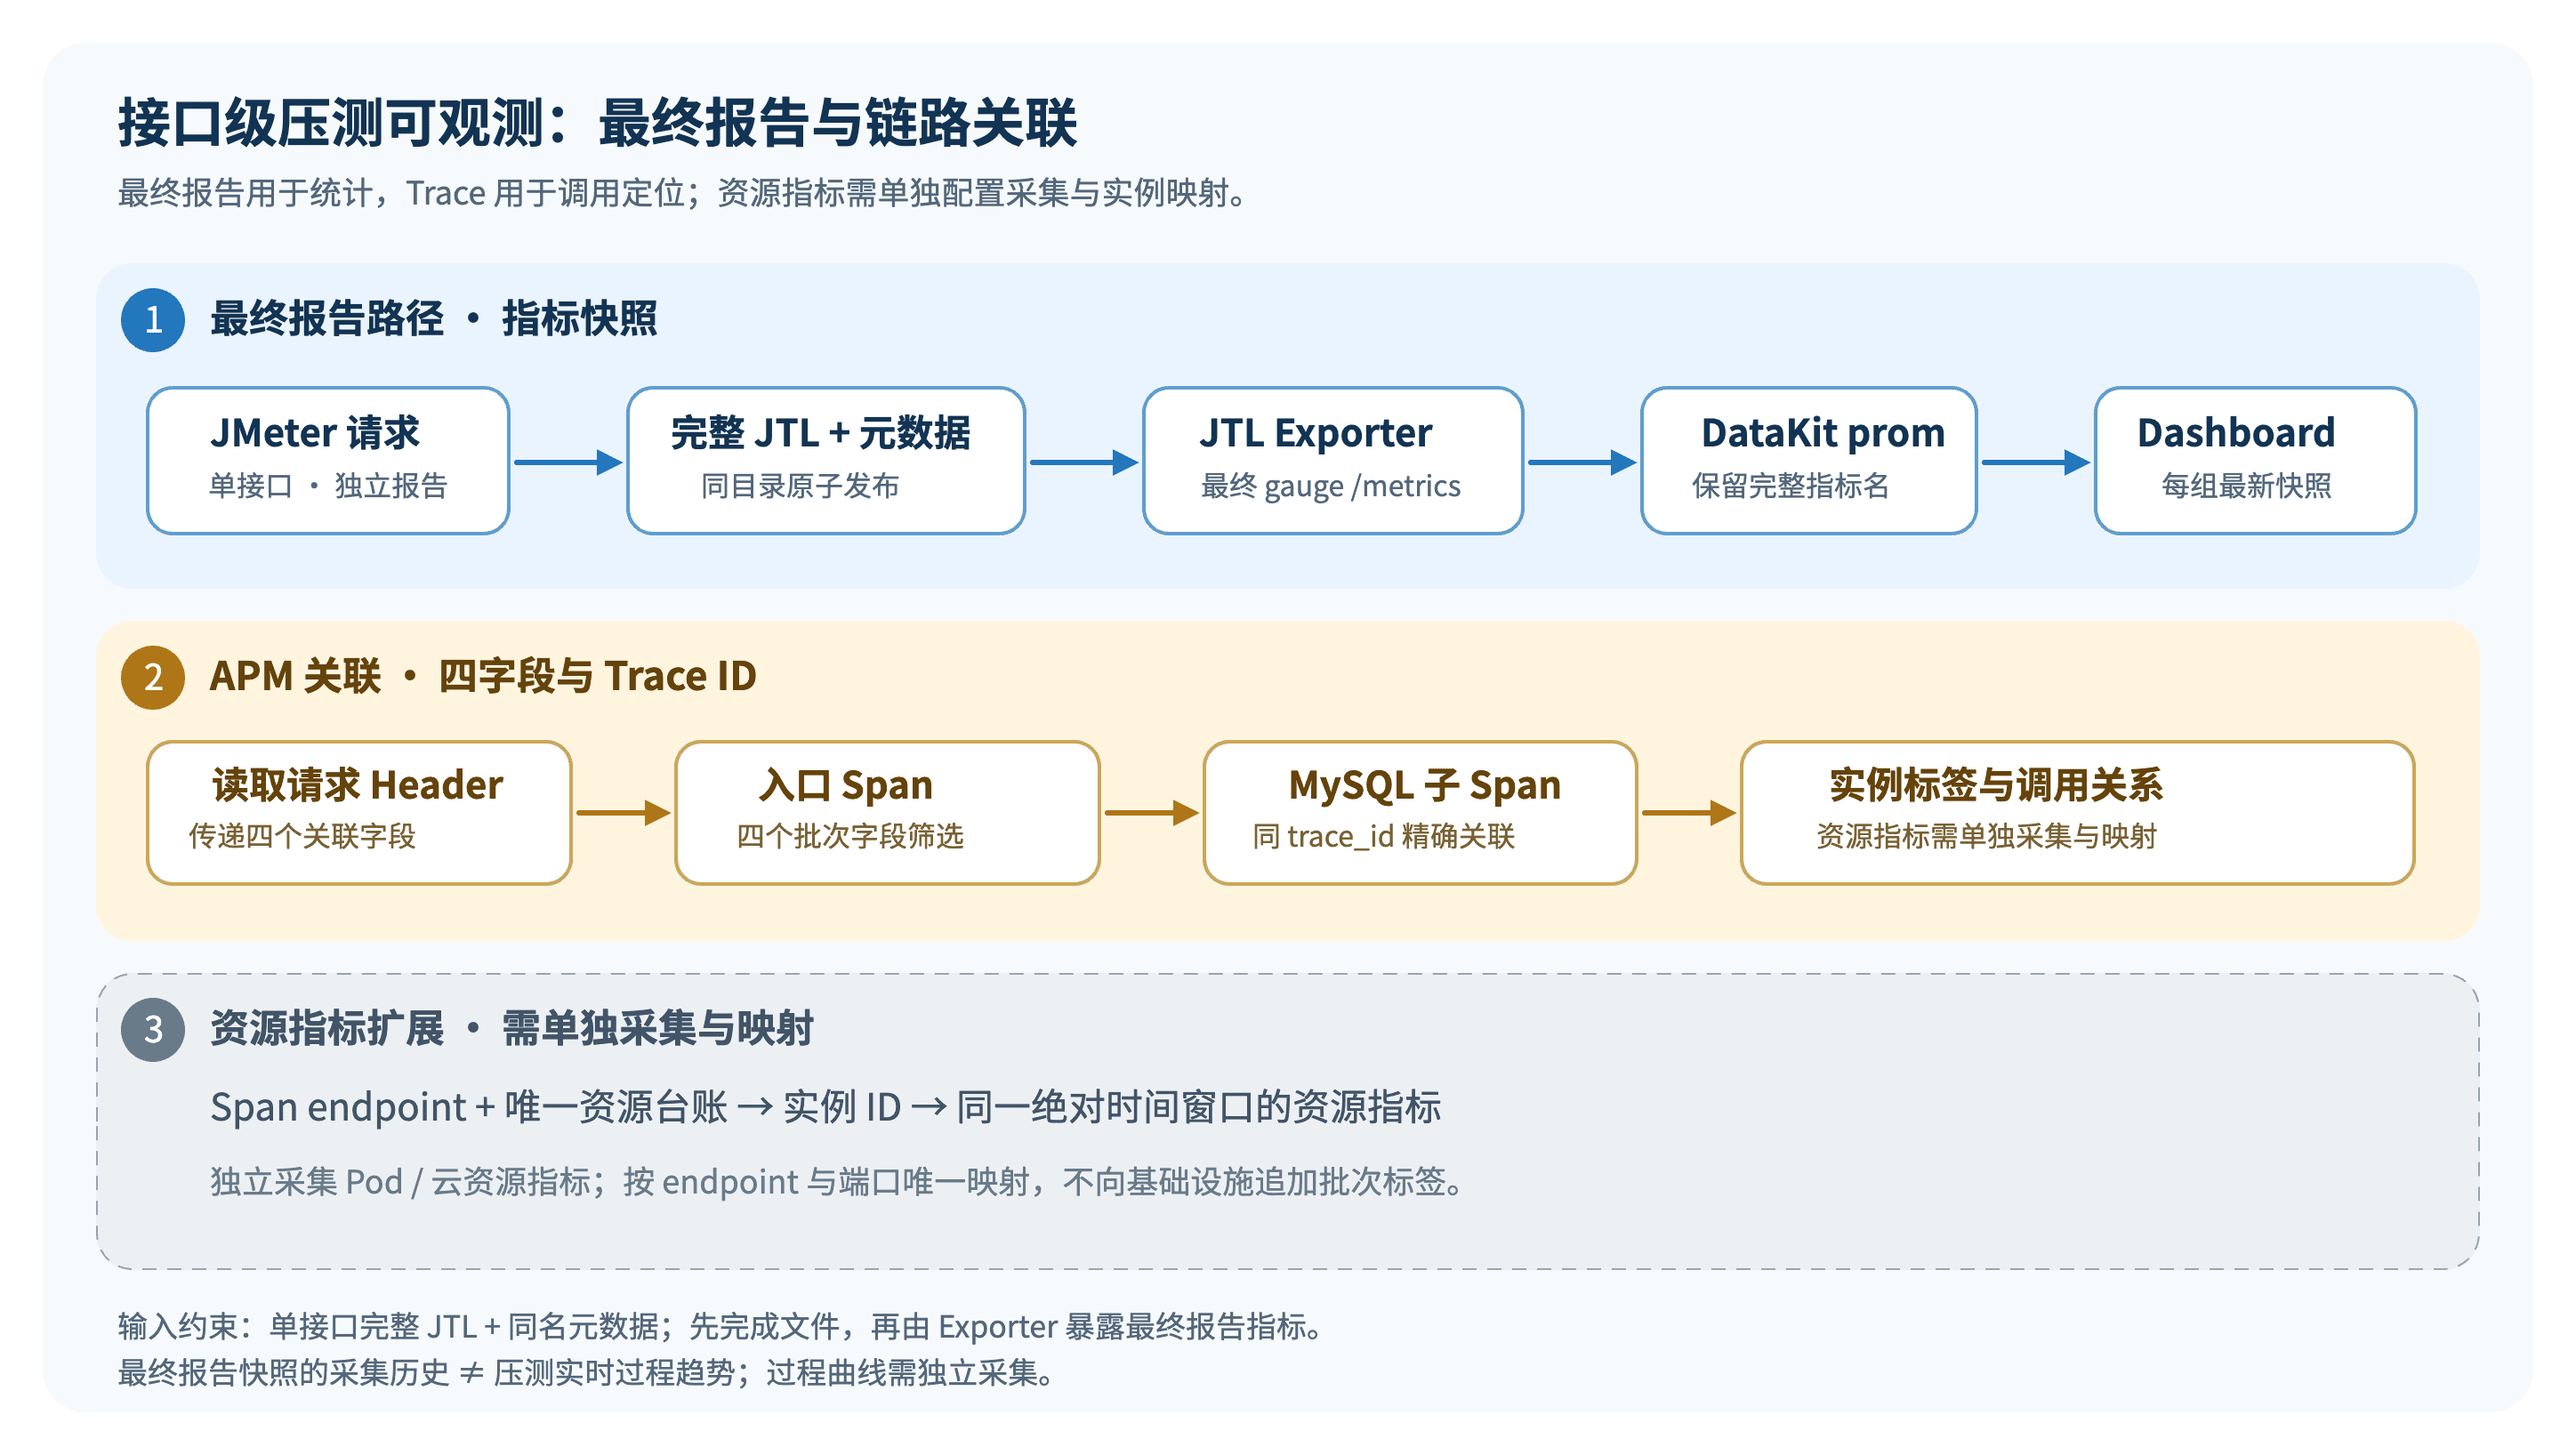
本方案适合单接口最终报告:一个完整文件对应一份报告,多接口分别输出。Exporter 持续暴露最终结果,不提供压测过程的实时 QPS/TPS 趋势,也不自动合并分布式分片。
最小示例只包含 HTTP 请求和报告指标;APM 探针、数据库及云资源采集需按实际应用另行接入。
环境准备
- Linux 或 macOS,建议使用已完成回归测试的 Python 3.11;Exporter 只依赖标准库,需支持 fcntl。
- 已安装 JDK、Apache JMeter 和 curl。随包 JMX 使用 JMeter 5.5 格式,其他版本需先验证兼容性。
- 已有 DataKit 和观测云工作空间写入权限,DataKit 能访问 Exporter。
- 准备可持久化的结果目录和 state 文件;下载文末参考包并解压,以下命令均在包根执行。
实施步骤
1. 统一批次标识
| 字段 | 作用 |
|---|---|
| scenario_id | 业务场景,例如 checkout |
| interface | 接口标识,例如 POST /orders |
| run_id | 本次执行批次,每次新执行使用新值 |
| report_id | 报告或报告集合标识,不能单独作为唯一查询条件 |
以 (report_id, run_id, scenario_id, interface) 共同标识一份最终报告,Header、metadata 和查询条件保持一致。
- 一个 .jtl.csv 只包含一个非空 sampler label,不混入父事务汇总行;不同文件不得复用同一组合身份。
- 文件发布后不再原地修改;更正报告时使用新路径和新组合身份。
- Exporter 从同名 .meta.json 或约定文件名读取上下文,不读取 JTL 行内的批次字段。
2. 运行示例与 Exporter
先创建目录,在终端 A 启动无数据库依赖的 HTTP 示例:
mkdir -p .work/results .work/state
python3 demo/http_app.py --bind 127.0.0.1 --port 8080
在终端 B 启动 Exporter:
python3 exporter/jtl_result_exporter.py \
  --watch-dir .work/results --state-file .work/state/state.json \
  --bind 127.0.0.1 --port 9108
在终端 C 运行 JMeter,等待文件稳定扫描后检查结果:
sh jmeter/run-demo.sh
curl -fsS http://127.0.0.1:9108/readyz
curl -fsS http://127.0.0.1:9108/metrics
脚本分别生成 GET /work 和 GET /missing 两份报告,预期前者 30 次成功、后者 5 次失败,用于检查正常与错误结果的统计。
JMX 在 User Defined Variables 中通过 ${__P(report_id)} 等表达式将 Property 写入同名 Variable,再由 Header Manager 使用:
X-Report-Id: ${report_id}
X-Run-Id: ${run_id}
X-Scenario-Id: ${scenario_id}
X-Interface: ${interface}
结果文件与 metadata 配对,例如 run-001.jtl.csv 和 run-001.meta.json:
{"report_id":"report-001","run_id":"run-001","scenario_id":"demo","interface":"GET /work"}
先原子发布 metadata;JMeter 写入 .jtl.csv.tmp,完成并关闭文件后,在同一文件系统改名为 .jtl.csv。这样可避免 Exporter 读取未完成的报告。
3. 关联 APM 链路(可选)
在已有 APM 探针的应用中,将请求 Header 保存为入口 Span 标签。以 Java DDTrace 为例,JVM 参数放在 -jar 之前:
-Ddd.trace.header.tags=X-Report-Id:report_id,X-Run-Id:run_id,X-Interface:interface,X-Scenario-Id:scenario_id
也可使用环境变量 DD_TRACE_HEADER_TAGS;其他语言按对应探针配置。入口 Span 应能按四个批次字段检索,子 Span 使用 trace_id 关联,不要求复制全部 Header 标签。配置项以实际探针版本的官方文档为准。
4. 理解报告指标
Exporter 缓存完整文件的统计结果,并通过 /metrics 持续暴露。所有 jmeter_jtl_report_* 指标均为最终快照 gauge,即使名称以 _total 结尾,也不能按 counter 求 rate,或将多次抓取值直接相加。
| 指标 | 口径 |
|---|---|
| 请求数、成功数、失败数 | 按 JTL 样本统计 |
| 平均响应时间、P95、P99 | 单位 ms;分位数采用最近秩 |
| 错误率 | 失败数 / 请求数,原始值为 0–1 |
| 报告时长、吞吐率 | 时长为首样本开始至最后样本结束,单位 s;吞吐率 = 请求数 / 时长 |
图上的采集时间是 DataKit 抓取时间,不是 JTL 样本时间。若需要压测过程趋势,需另行采用实时采集或按事件时间分桶。
默认本地指标暴露 7 天;源文件仍在扫描目录时保留去重记录,移出后状态再保留 30 天。本地 TTL 不删除云端历史数据。state 文件须持久化,避免旧报告重新计入。
5. 接入 DataKit
采集报告指标
将 templates/datakit-prom.conf 放入已有 DataKit 的采集器配置目录,不覆盖其他采集器配置。若 DataKit 与 Exporter 不在同一主机或容器,请将抓取地址改为可达的内网端点,同时调整 Exporter 的 --bind 监听地址并限制访问来源。
[[inputs.prom]]
  urls = ["http://127.0.0.1:9108/metrics"]
  source = "jtl_result_exporter"
  measurement_name = "jmeter_real_e2e_verify"
  keep_exist_metric_name = true
  interval = "10s"
  election = false
指标集和完整字段名须与随包 Dashboard 一致;source 是采集器别名。单实例示例只使用一个 DataKit 抓取,多实例部署需配置采集归属或选举,避免重复采集。
保留 APM 批次标签
[[inputs.ddtrace]]
  customer_tags = ["report_id", "run_id", "interface", "scenario_id"]
customer_tags 用于保留可直接筛选的一级自定义标签。Kubernetes 可使用下列环境变量,并将 ddtrace 加入已有 ENV_DEFAULT_ENABLED_INPUTS 列表:
env:
  - name: ENV_INPUT_DDTRACE_CUSTOMER_TAGS
    value: '["report_id","run_id","interface","scenario_id"]'
保留数组/JSON 格式,不要改为普通逗号字符串。完成配置后,按部署方式重启或重载 DataKit 使配置生效。
扩展:关联资源指标
如需继续定位资源瓶颈,可从中间件 Span 的实际调用目标映射到云实例,再查询同一压测时间窗口内的资源指标。该部分需要单独配置采集与映射。
- 先抽样确认真实 Span 字段。例如 server.address / server.port 或探针输出的 db_host / db_port;不要假设不同 SDK 的字段完全一致。
- 使用 CMDB 或资源台账,以 endpoint、port、环境和账号等维度建立唯一映射。Reference Table 默认取第一条匹配,发布映射前应处理重复项,并验证未匹配、冲突和资源下线场景。
- 以实例 ID + 压测绝对起止时间查询 CPU、连接数、IO 等实际指标,不给基础设施原始指标追加 report_id/run_id。
配置方法参考文末的 Pipeline Reference Table 文档。
Dashboard 使用
导入参考包中的 dashboard/jmeter_e2e_verify.json。模板分为最终报告、快照采集历史和 APM 关联三部分。
| 区域 | 阅读方式 |
|---|---|
| 报告 KPI / 明细表 | 按完整报告身份取最新快照,每组显示一行 |
| 快照采集历史 | 反映最终值被持续抓取的记录,不代表实时 QPS/TPS 或延迟走势 |
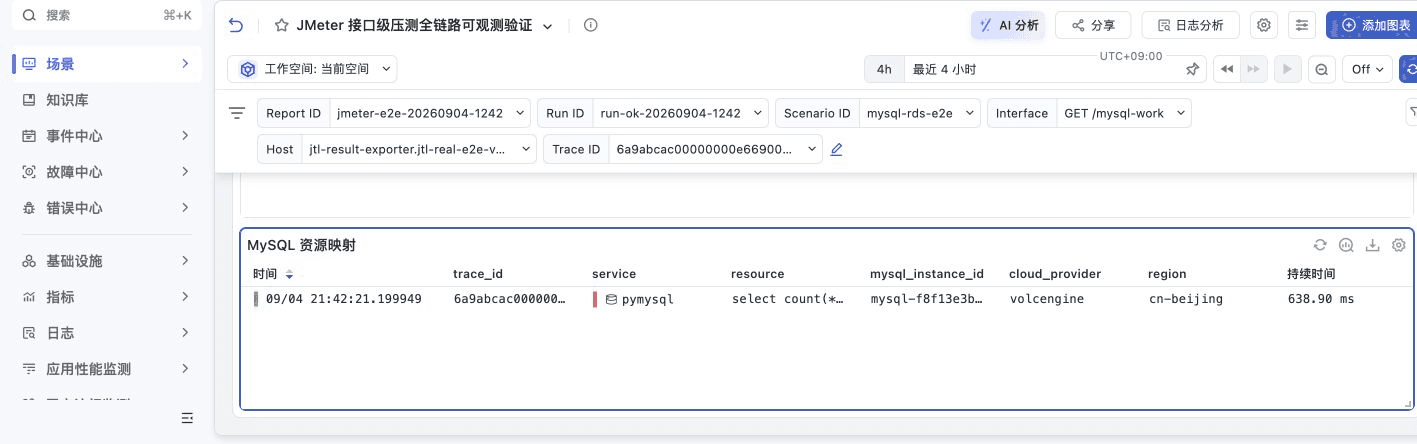
| APM 关联 | 按批次找入口 Span,再以同一 trace_id 查看 MySQL 子 Span |
- 确认指标集为 jmeter_real_e2e_verify,字段名和单位与包内 CSV 一致。
- 同时选择 report_id、run_id、scenario_id、interface,并定位单一 Exporter 的 host,避免报告或采集源混合。
- 使用 APM 时选择真实的单个 Trace ID,并将模板中的服务名称改为本环境名称;最小 HTTP 示例未接探针时,APM 表为空。
- 查询历史链路时使用覆盖执行时段的绝对时间窗口。模板不根据 report_id 自动切换时间范围。
部署与告警建议
- JMeter 与 Exporter 必须访问同一结果目录。随包 Kubernetes 示例为单节点、单副本;RWO/本地卷需安排在同一节点,多节点场景另选合适的共享存储。
- 同一 state 文件只允许一个进程写入。示例使用 Recreate 更新策略,避免新旧 Pod 同时持有状态锁;生产部署需评估更新期间的中断。
- /healthz 仅检查 HTTP 存活;/readyz 反映扫描是否就绪。监控就绪状态、扫描错误、最近成功扫描时间及 /metrics 缺失。
- 错误率、P95/P99 门禁按新报告身份评估并去重,阈值由业务目标确定,不对重复抓取结果反复告警。
运行后自检
- 检查最终文件、metadata、唯一报告身份和原子发布顺序。
- 对照原始 JTL、本地 /metrics 与云端查询,核对请求数、错误率、耗时和单位。
- 验证报告表每组只显示一行,并检查无指标、坏文件和重复身份时的诊断表现。
- 需要 APM 时检查入口的四标签与父子 Span 的 trace_id;资源扩展须单独验证映射和实际资源读数。
效果示例
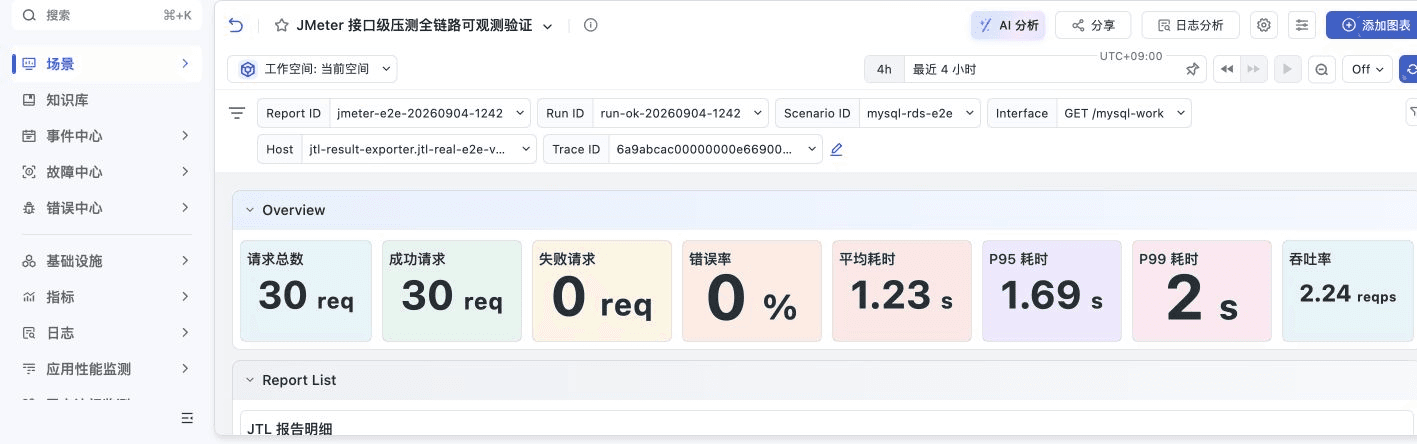
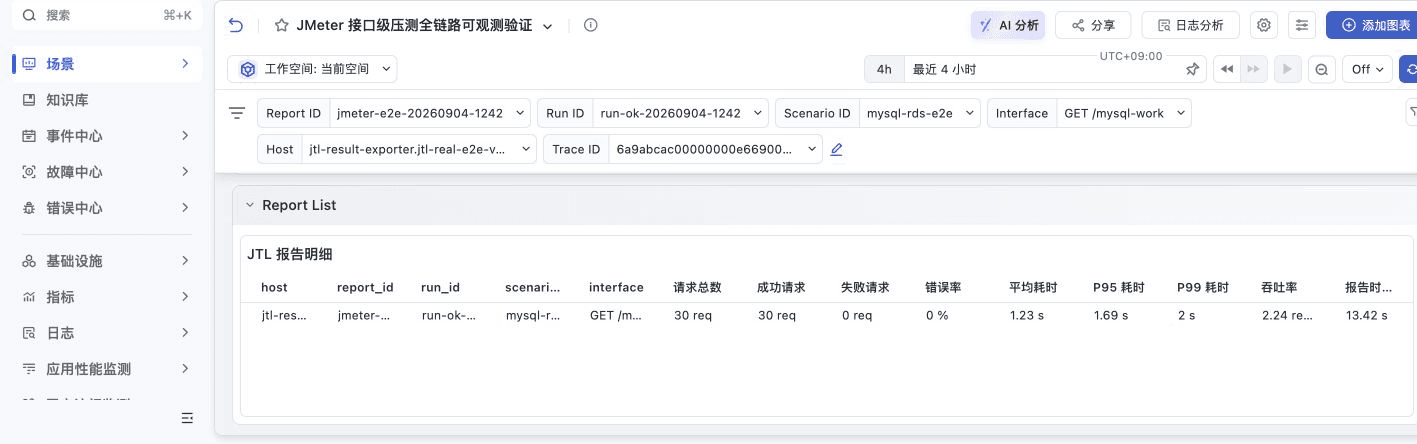
以下结果来自 2026-09-04 的 JMeter 5.5、单节点 Kubernetes 与 MySQL 示例环境,展示正常请求和 404 请求的最终报告。Source: OpenAPI(OWL),与原始 JTL 和 Exporter /metrics 对照;截图来自观测云 Console。
| 指标 | GET /mysql-work | GET /missing |
|---|---|---|
| 请求总数 | 30 | 5 |
| 成功 / 失败 | 30 / 0 | 0 / 5 |
| 错误率 | 0% | 100% |
| 平均响应时间 | 1231.17 ms | 22.8 ms |
| P95 / P99 | 1692 / 2000 ms | 103 / 103 ms |
| 吞吐率 | 2.235 req/s | 42.017 req/s |
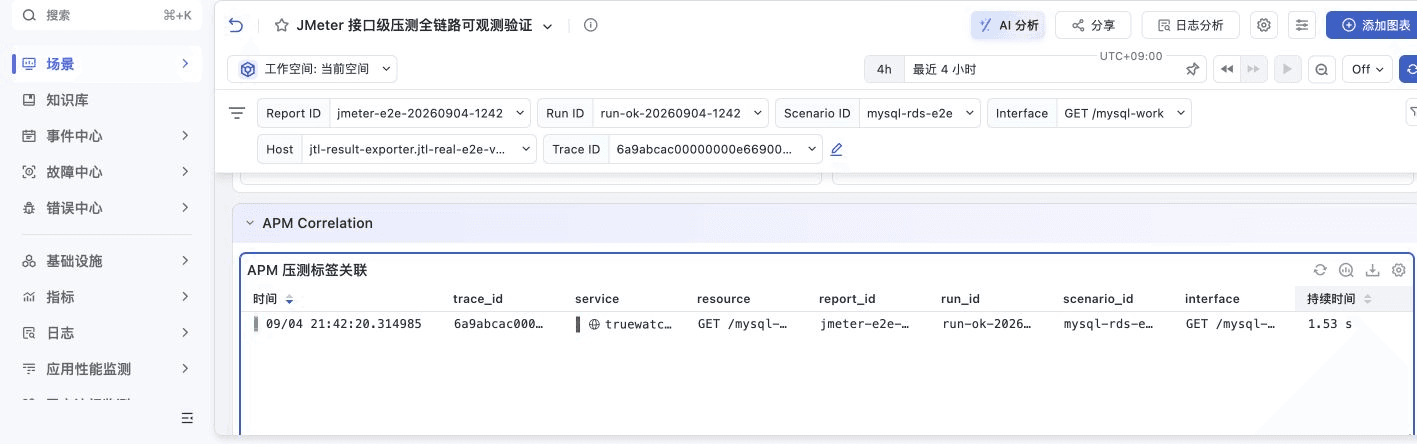
正常批次展示了报告 → 入口 Trace → MySQL 子 Span 的关联;404 场景仅核对报告指标,云资源指标未包含在本例中。小样本用于说明数据关联方法,不作为容量或性能基线。
报告概览与明细表按组合身份展示最终结果:
同一 Trace 中,入口 GET /mysql-work 耗时 1.53 s,MySQL 子调用耗时 638.90 ms。用 trace_id 定位同一链路,再结合 parent_id 或调用树确认父子关系,查看子 Span 的实例标签与调用信息:
常见问题
| 现象 | 排查方向 |
|---|---|
| 文件已生成但无指标 | 检查 .jtl.csv 后缀、同名 metadata、稳定等待时间及共享目录 |
| /healthz 正常,/readyz 返回 503 | 检查首轮扫描、坏 metadata、混合 label、重复身份、目录权限和扫描是否过期 |
| 请求数放大或报告混合 | 不要累加重复抓取值;检查组合身份与 host,并排除重复采集 |
| 采集正常,Dashboard 为空 | 检查指标集、完整字段名、筛选变量、服务名称和时间窗口 |
| 子 Span 缺少批次标签 | 按 trace_id 关联入口与子 Span,不要求子 Span 继承全部 Header |
| 过期报告再次出现 | 检查 state 是否丢失、旧文件是否被重新投递,并完善归档策略 |
安全注意事项
- API Key、数据库凭据和采集 Token 放在受控运行配置中,不写入 Header、JTL、Trace Tag 或 Dashboard URL。
- Exporter 端口只向必要的采集端开放;嵌入 Dashboard 时遵循工作空间访问权限。
- 仅向获授权的人员共享包含业务、环境或实例标识的视图。
总结
通过统一的批次标识,JMeter 最终报告与 APM 调用信息可以围绕同一次测试展开分析:报告用于评估接口整体表现,链路用于追溯具体调用的耗时。这让压测复盘能够从“结果是否达标”进一步走向“哪些环节值得排查”,也为测试、开发与运维协作提供共同的数据依据。
落地时,建议从单接口、单批次开始,先核对 JTL、Exporter 与 Dashboard 的统计一致性,再接入实际应用的 APM;资源指标则在完成独立采集与实例映射后逐步扩展。以清晰的统计口径和可追溯的关联关系为基础,逐步形成可复用的接口性能分析流程。