观测云 DataFlux Func 实践:打造可复用的可视化大屏数据服务
本文介绍如何基于观测云 DataFlux Func 构建可复用的大屏数据服务,通过统一查询、指标加工、定时缓存与 API 封装,已实现 200+ 指标和 200+ 数据接口,助力多行业大屏建设,降低重复开发与维护成本。
DataFlux Func 将数据查询、指标加工和接口封装集中组织为可复用的数据服务,为不同业务应用提供统一的数据接口。本文结合已实现的可视化大屏实践,以一个具体指标为例,介绍从数据连接、查询加工到接口发布和大屏对接的完整流程。
背景与挑战
观测云已接入多种数据,为项目提供了统一的数据查询基础。在此基础上,数据查询、指标加工和接口开发仍存在大量共性需求。如果这些能力分散在各项目中独立实现,就容易出现查询逻辑重复开发、指标口径分别维护、接口难以复用等问题。当数据来源或业务规则发生变化时,还需要逐一调整相关项目,增加维护和协作成本。
这些问题背后的共同需求,是建立一层可共享的数据服务:向下连接数据来源,集中管理查询与加工逻辑;向上提供统一、可复用的接口,让不同应用能够基于同一套数据能力完成业务展示。可视化大屏是其中一个典型场景,不同专题虽然展示内容各异,但底层的数据处理能力可以共用。
本实践以 DataFlux Func 为核心,结合观测云的数据接入与查询能力,构建可供多个项目共享的数据服务层。通过在 Func 中集中维护指标口径、处理逻辑和接口约定,将项目中的共性能力沉淀为可复用服务,为多个专题大屏提供支撑。新项目可以沿用已有连接、函数和接口,主要补充业务差异,减少重复开发。
以 Func 为核心构建大屏数据服务
DataFlux Func(以下简称 Func)是这套方案的数据服务核心,负责连接观测云、执行查询,并将指标加工结果封装为大屏可以直接调用的接口。查询逻辑、指标口径和返回结构在 Func 中集中维护,观测云提供底层数据接入与查询能力,大屏端则依据统一的数据约定完成展示。
在具体的数据处理过程中,Func 从观测云查询指标,完成字段映射、聚合和返回结构整理,再通过函数 API 向大屏提供数据。对于按周期更新的指标,可由定时任务提前完成查询与加工,将结果写入 DFF.STORE,供接口读取。下图展示了查询、加工与接口调用之间的关系,以及定时缓存的处理路径。
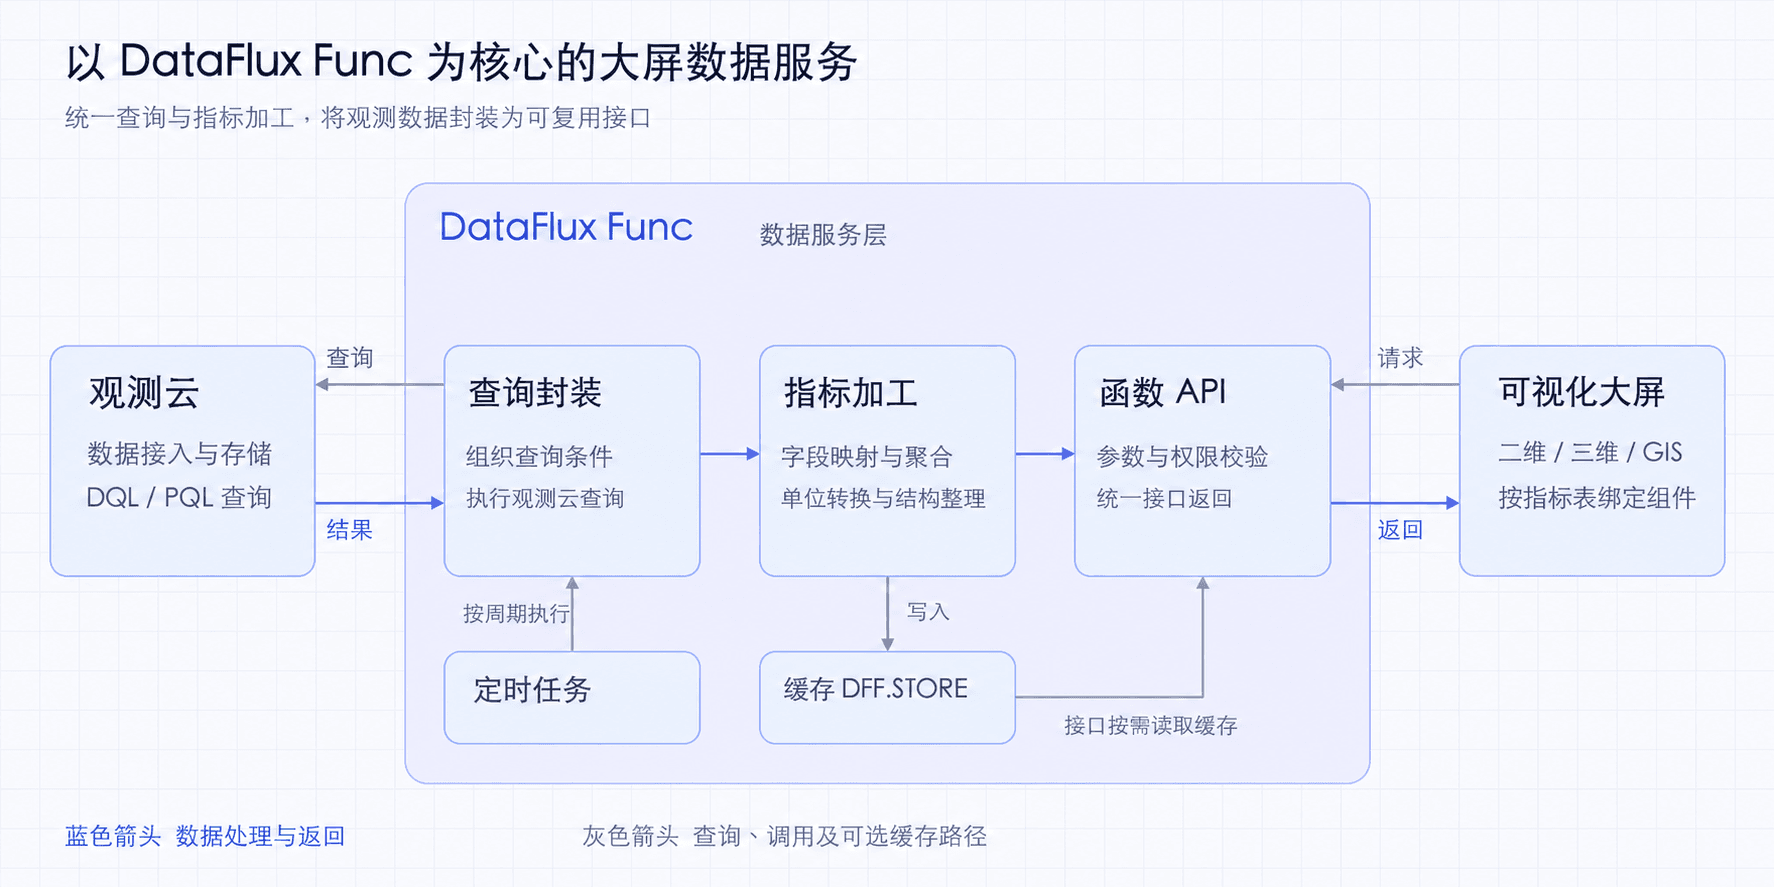
Func 数据查询与定时缓存流程
下表从数据接入、指标口径、接口对接及后续维护等方面,对比各项目独立开发与基于 Func 构建共享数据服务的差异。
| 对比维度 | 各项目分别开发数据接口 | 基于 Func 的通用方案 |
|---|---|---|
| 数据接入 | 各项目分别实现连接与查询逻辑 | 复用连接配置和公共查询逻辑 |
| 指标口径 | 分散在各项目中,需要分别核对 | 在 Func 中集中维护,供不同页面调用 |
| 大屏对接 | 逐项沟通接口、参数与字段含义 | 通过指标表明确对应关系,大屏按表配置 |
| 需求变更 | 相同逻辑可能需要在多个项目中修改 | 复用同一服务的页面可共享调整结果;接口约定不变时,前端可减少修改 |
| 新项目建设 | 重复编写相似的数据处理与接口代码 | 复用已有能力,主要补充业务差异 |
| 问题排查 | 分别检查各项目的数据处理逻辑 | 按指标表追溯对应接口、处理逻辑与数据来源 |
数据接入与展示实践
下面以“ECS 集群资源库存—主中心 CPU 库存—CPU 总量”为例,将指标定义、观测云查询、Func 加工与缓存、接口发布和大屏对接串成一条完整流程。该指标的原始数据来自 Prometheus,经过观测云查询与 Func 处理后,作为容量水位数据的一部分提供给大屏。
建立数据连接
Func 通过连接器集中管理外部数据源的连接信息,脚本可以按连接器 ID 引用,便于在不同处理任务中复用。在“开发 / 连接器”中创建连接时,先根据接入方式选择类型,再填写连接信息。下图展示了可选的观测云、DataKit 和 DataWay 等连接器类型。
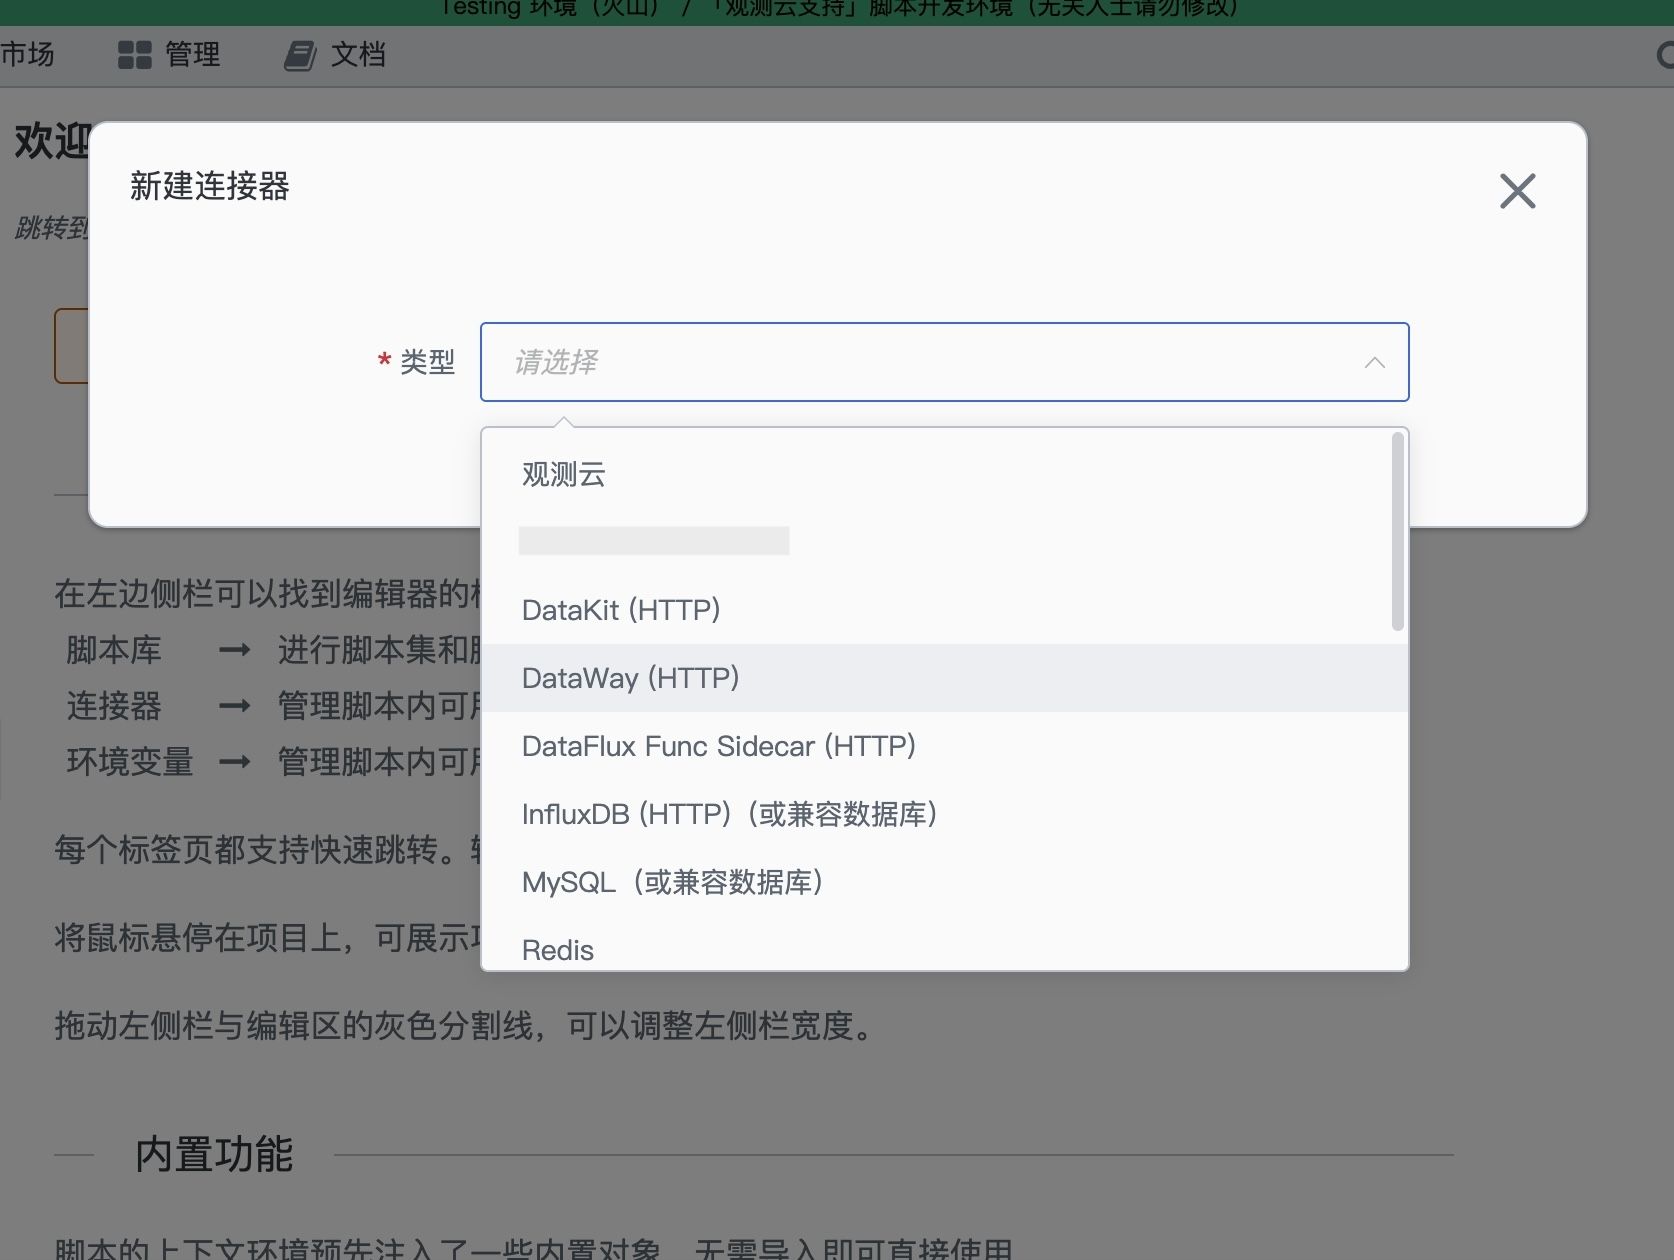
在 Func 中选择连接器类型
以 DataWay 连接配置为例,设置连接器 ID dataflux_dataway,并按实际环境填写主机、端口、协议和访问凭据,测试连通性后保存。连接信息集中维护后,脚本便可通过 ID 获取对应连接。
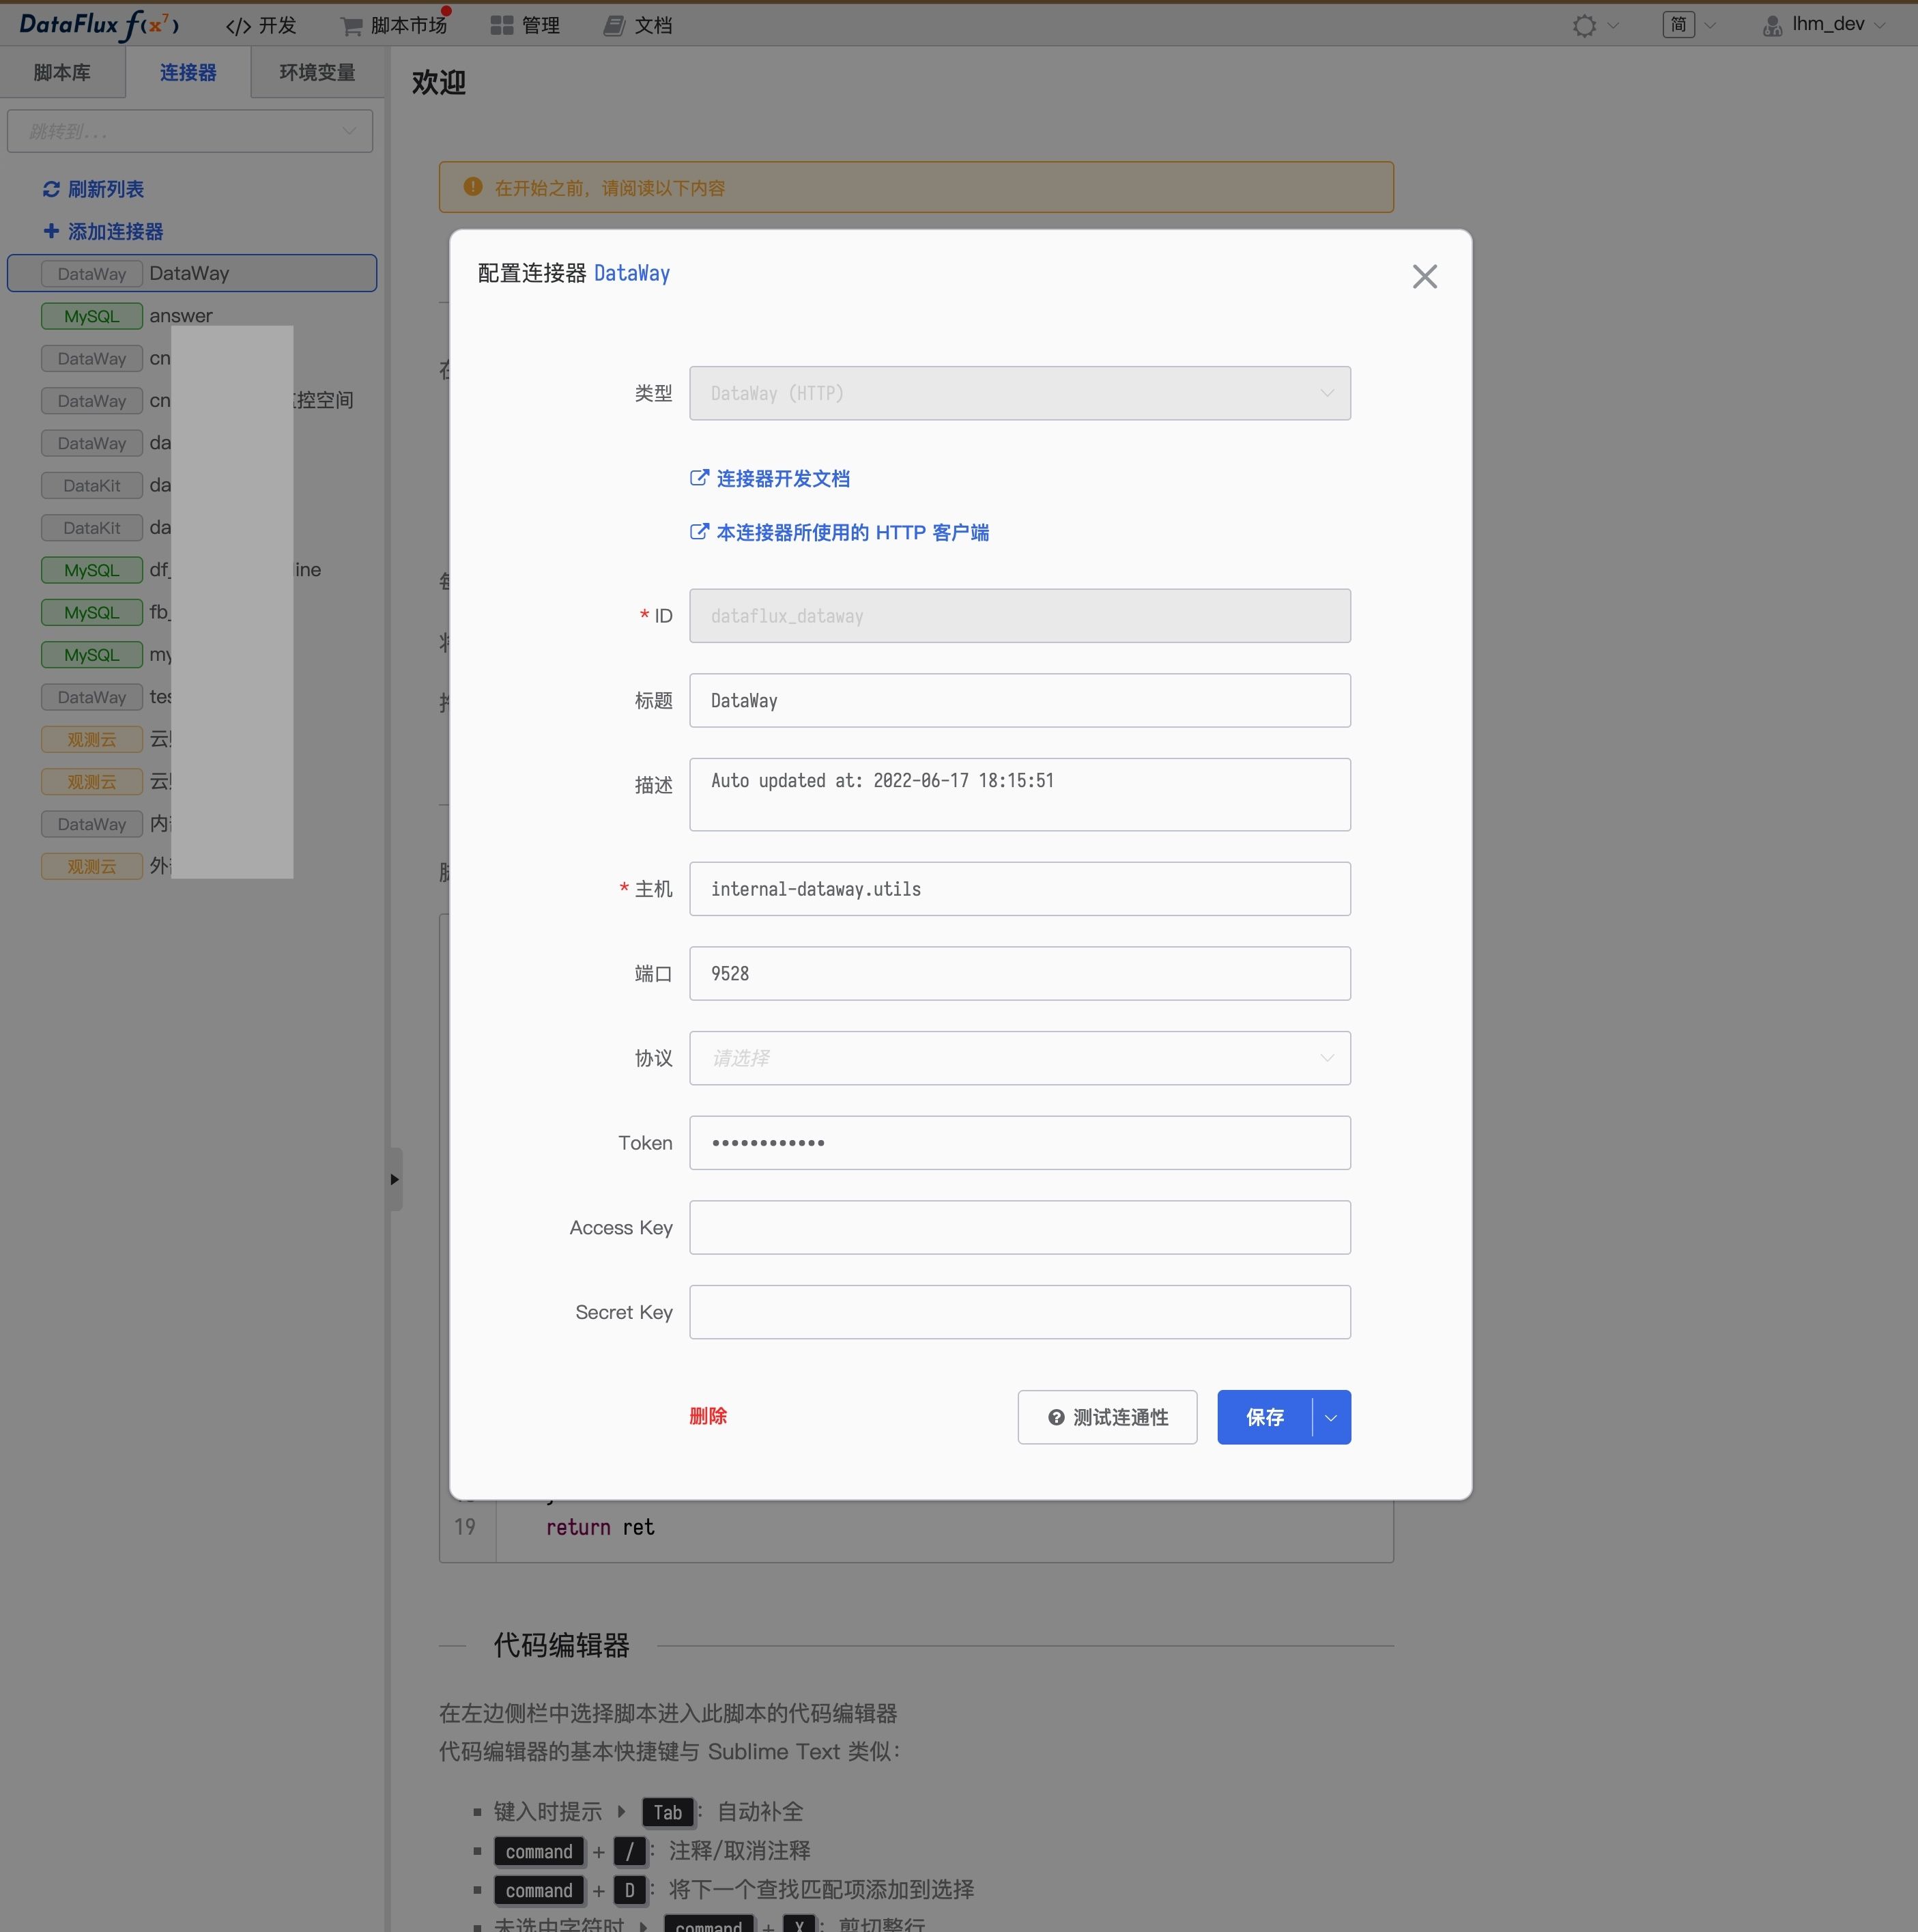
DataWay 连接配置
调用时,通过 DFF.CONN("dataflux_dataway") 获取连接器对象,再使用 write_metric、write_logging 写入指标和日志。这里展示的是数据写入方式;后文 CPU 总量示例读取的是已接入观测云的数据,通过查询 API 和工作空间 API Key 获取结果。两者分别承担数据接入与数据查询的职责。
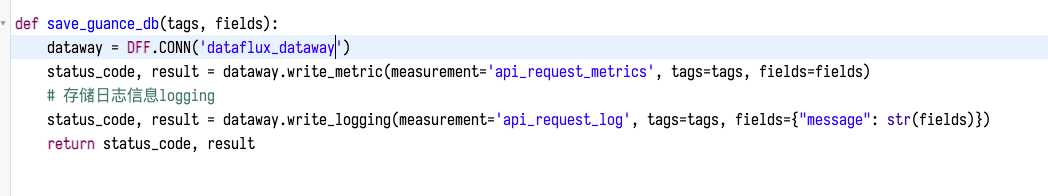
通过连接器写入指标和日志
确定指标口径与访问条件
指标表是开发和联调的共同依据。本例先确定 CPU 总量的统计对象、数据来源、查询语句与更新频率,后续查询和接口核对都沿用同一口径。指标表中,CPU 总量的数据来源为 prom,更新频率为 1h;这些约定需要与实际数据更新和大屏刷新需求保持一致。
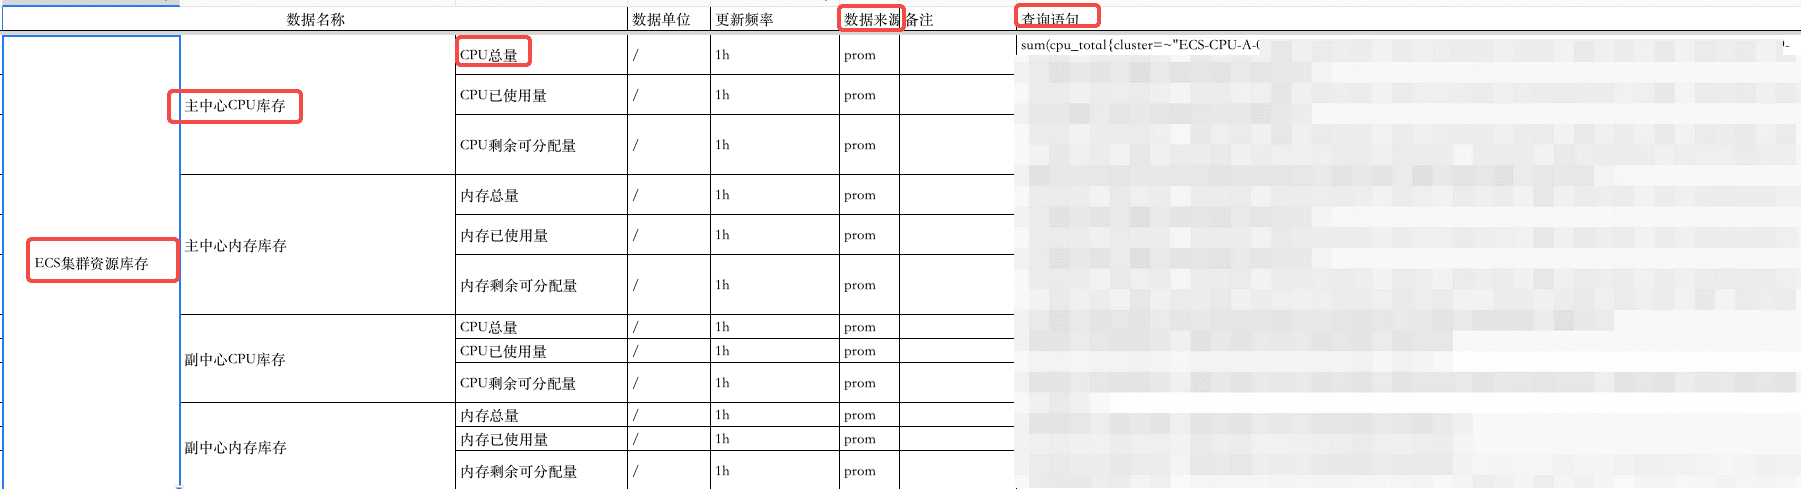
CPU 总量指标定义与查询约定
开始查询前,准备可使用的 Func 环境、已接入目标数据的观测云工作空间,以及对应节点和工作空间 API Key,并确认 Func 能够访问观测云 API。API Key 用于 Func 向观测云发起查询请求。
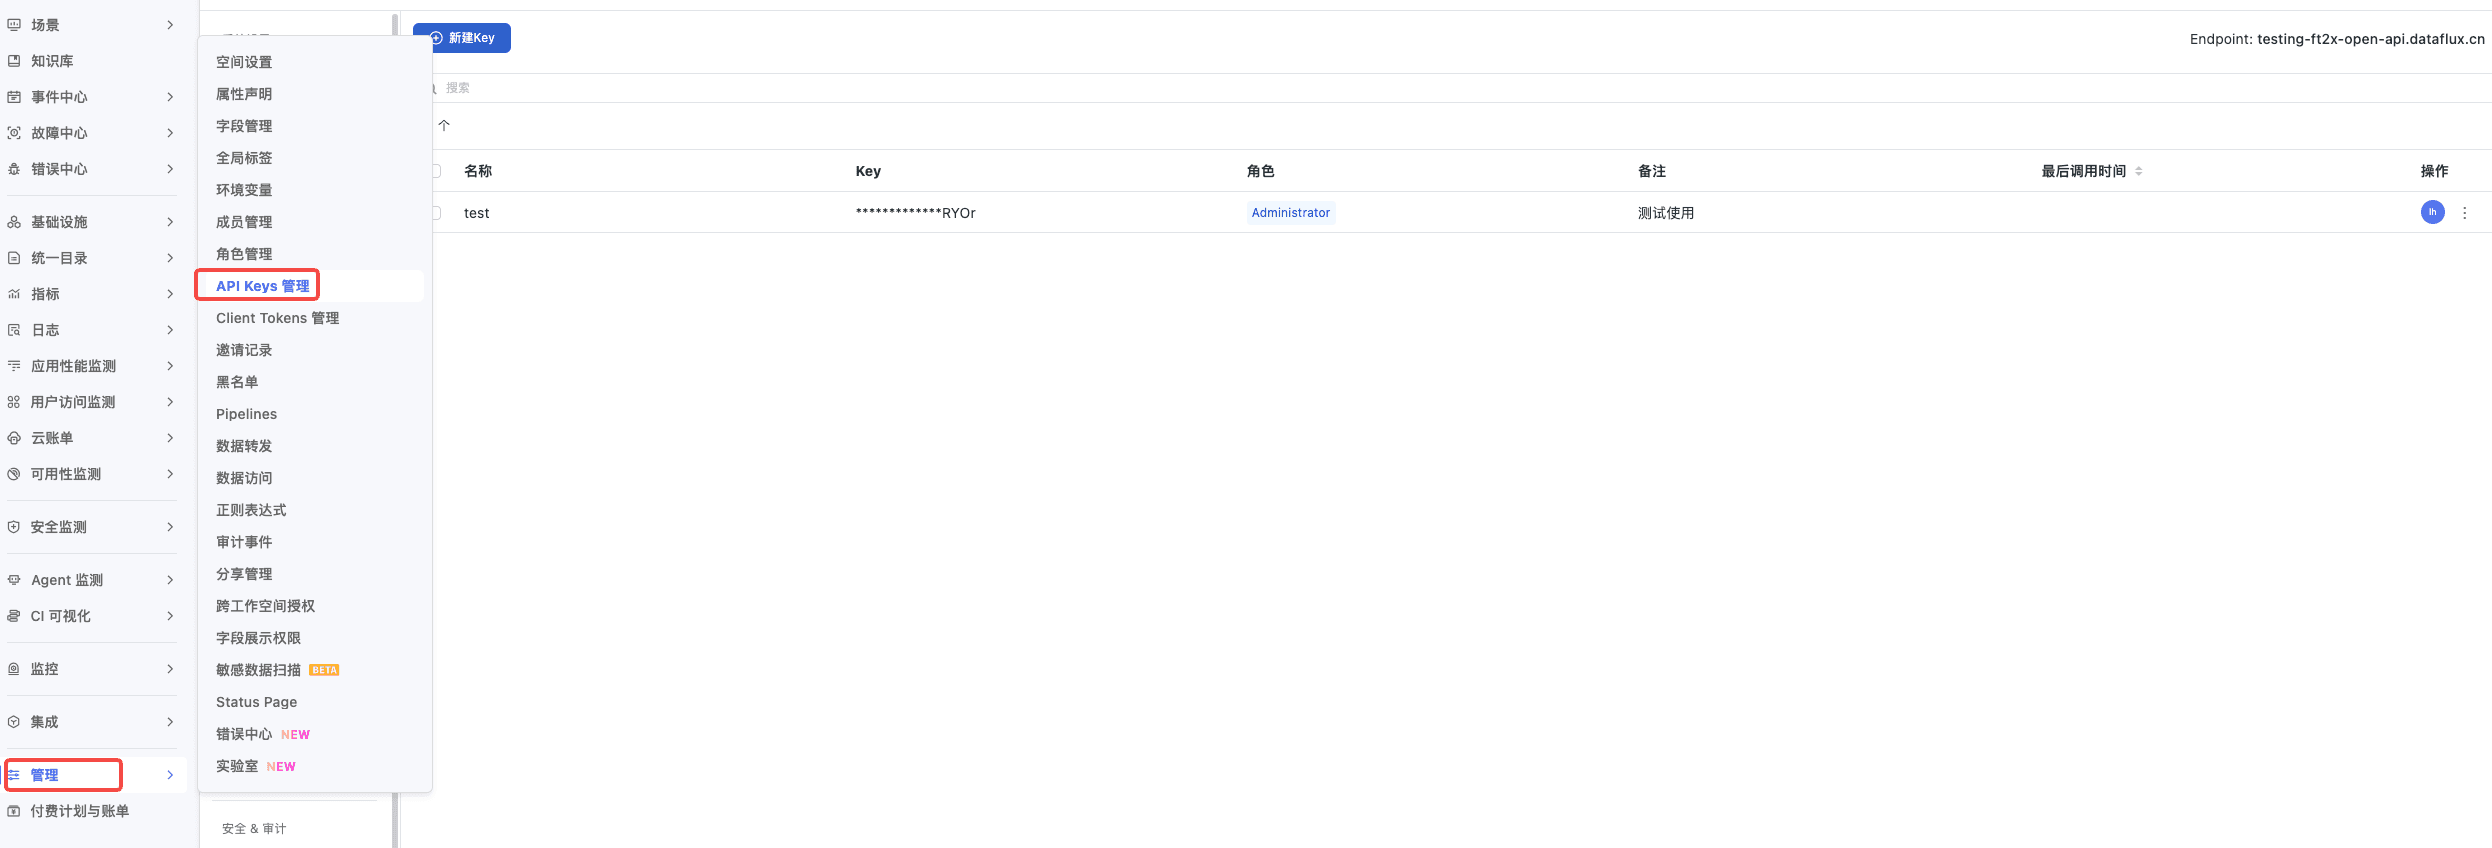
观测云 API Key 管理入口
核对 PQL 查询并接入 Func
本例通过观测云支持的 PQL 语句查询 CPU 总量,下图展示了查询语句及返回结果。目标集群与统计范围沿用指标表中的约定,查询结果作为后续 Func 接口返回值的核对依据。
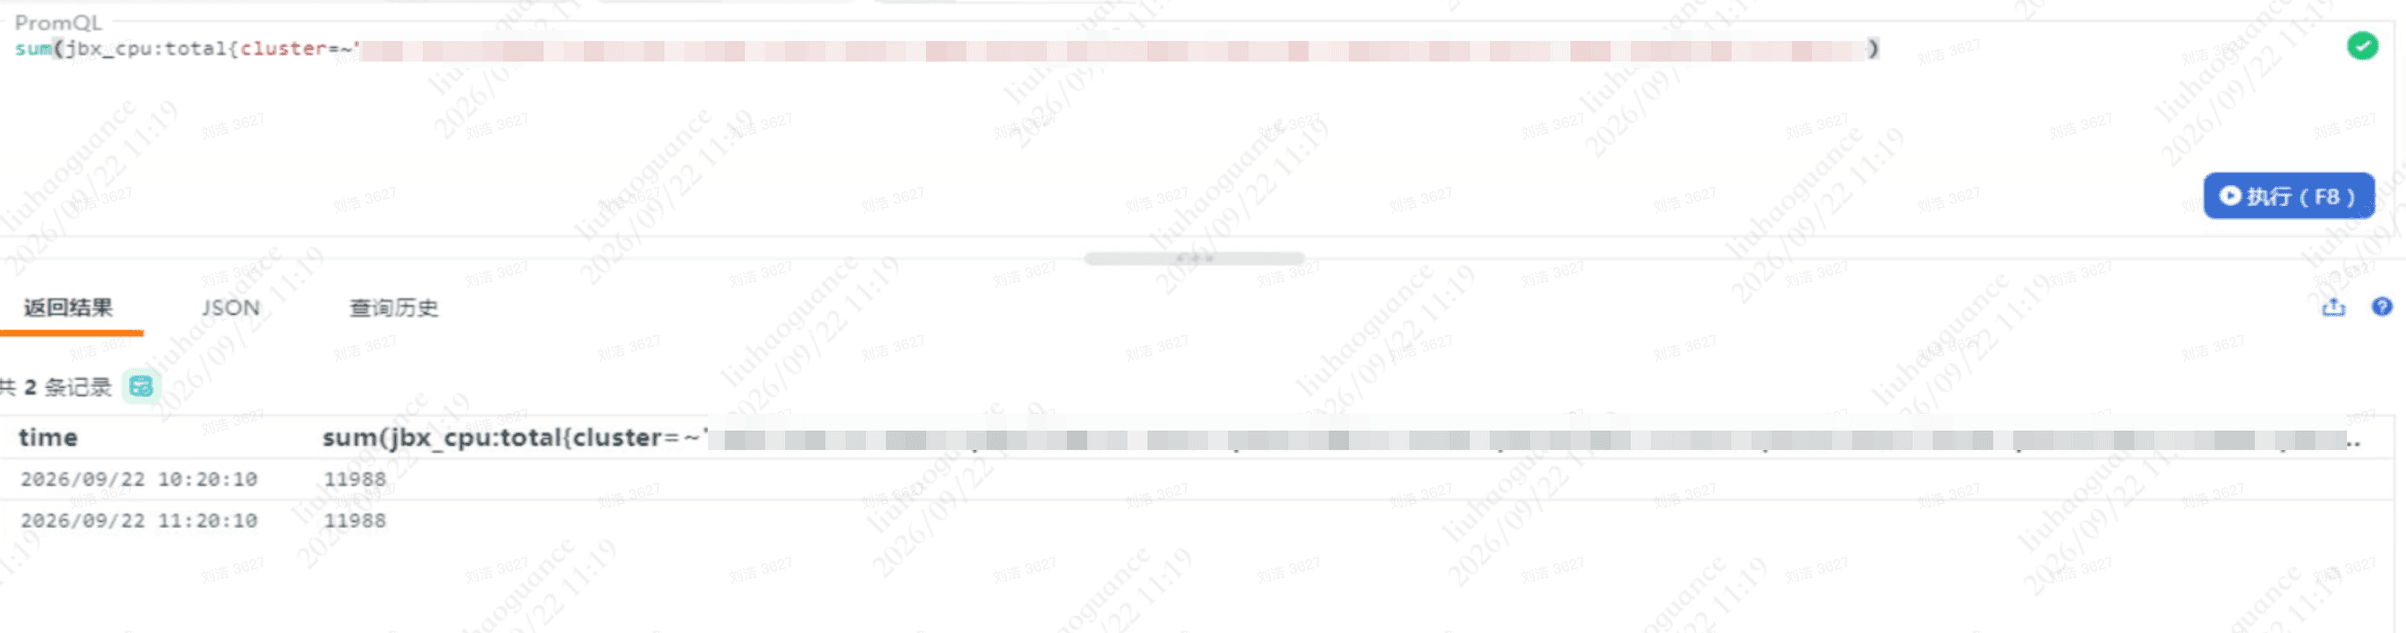
在观测云核对 CPU 总量查询结果
查询验证通过后,在 Func 中封装公共查询函数,传入 PQL 语句和时间范围,并通过请求头携带 API Key。示例函数将起止时间转换为毫秒时间戳,时区设置为 Asia/Shanghai,再向对应节点的查询 API 发起请求。公共函数负责请求与结果获取,具体指标的查询语句由业务逻辑传入,其他指标也可以复用这一入口。
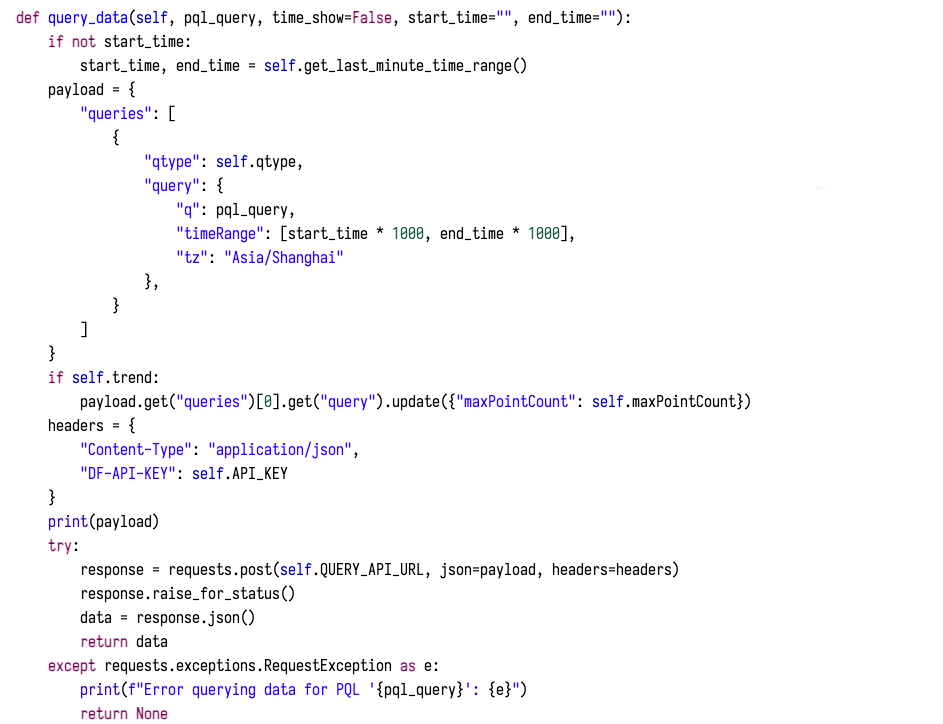
Func 中的 PQL 查询函数
整理容量指标并通过定时任务更新缓存
取得查询结果后,Func 将指标整理为容量水位数据。下文的接口返回值截图中,CPU 总量对应字段为 ecs_cpu_total。它是本例的业务返回字段,其他容量指标可按同样方式整理到返回结构中。字段映射、计算方式和单位在 Func 中统一维护,大屏依据约定字段读取结果。
为配合周期性刷新,容量水位缓存函数按 master、node、total 等索引获取并组织数据,通过 DFF.STORE.set 写入缓存。不同索引使用对应的缓存键,入口函数再按相同约定读取,避免不同范围的结果混用。
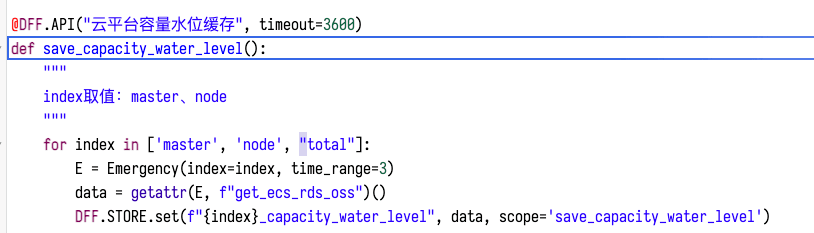
容量水位数据加工与缓存写入
将缓存函数配置为定时任务后,Func 持续执行查询和更新,大屏请求即可读取已经整理好的结果,减少重复查询。任务频率需要结合指标更新周期设置,并通过运行状态确认任务正常执行;后续新增同类指标时,可以沿用这一调度与缓存方式。

容量水位定时任务运行状态
封装函数 API 并核对返回值
缓存准备好后,入口函数 get_capacity_water_level 接收 index 参数,通过 DFF.STORE.get 读取对应的容量水位数据并返回。使用 @DFF.API(...) 导出函数后,在“管理 / 函数 API”中创建供大屏调用的入口。查询与加工由定时任务完成,接口负责按请求参数提供结果。
联调时先在 Func 中以 index="master" 执行入口函数,检查 CPU 总量对应的返回字段。下图底部红框显示 ecs_cpu_total 的值为 11988.0,与前面的观测云查询截图一致。核对时应采用相同的统计对象与查询时间范围,并考虑缓存更新时间,确认接口结果与观测云查询结果一致。
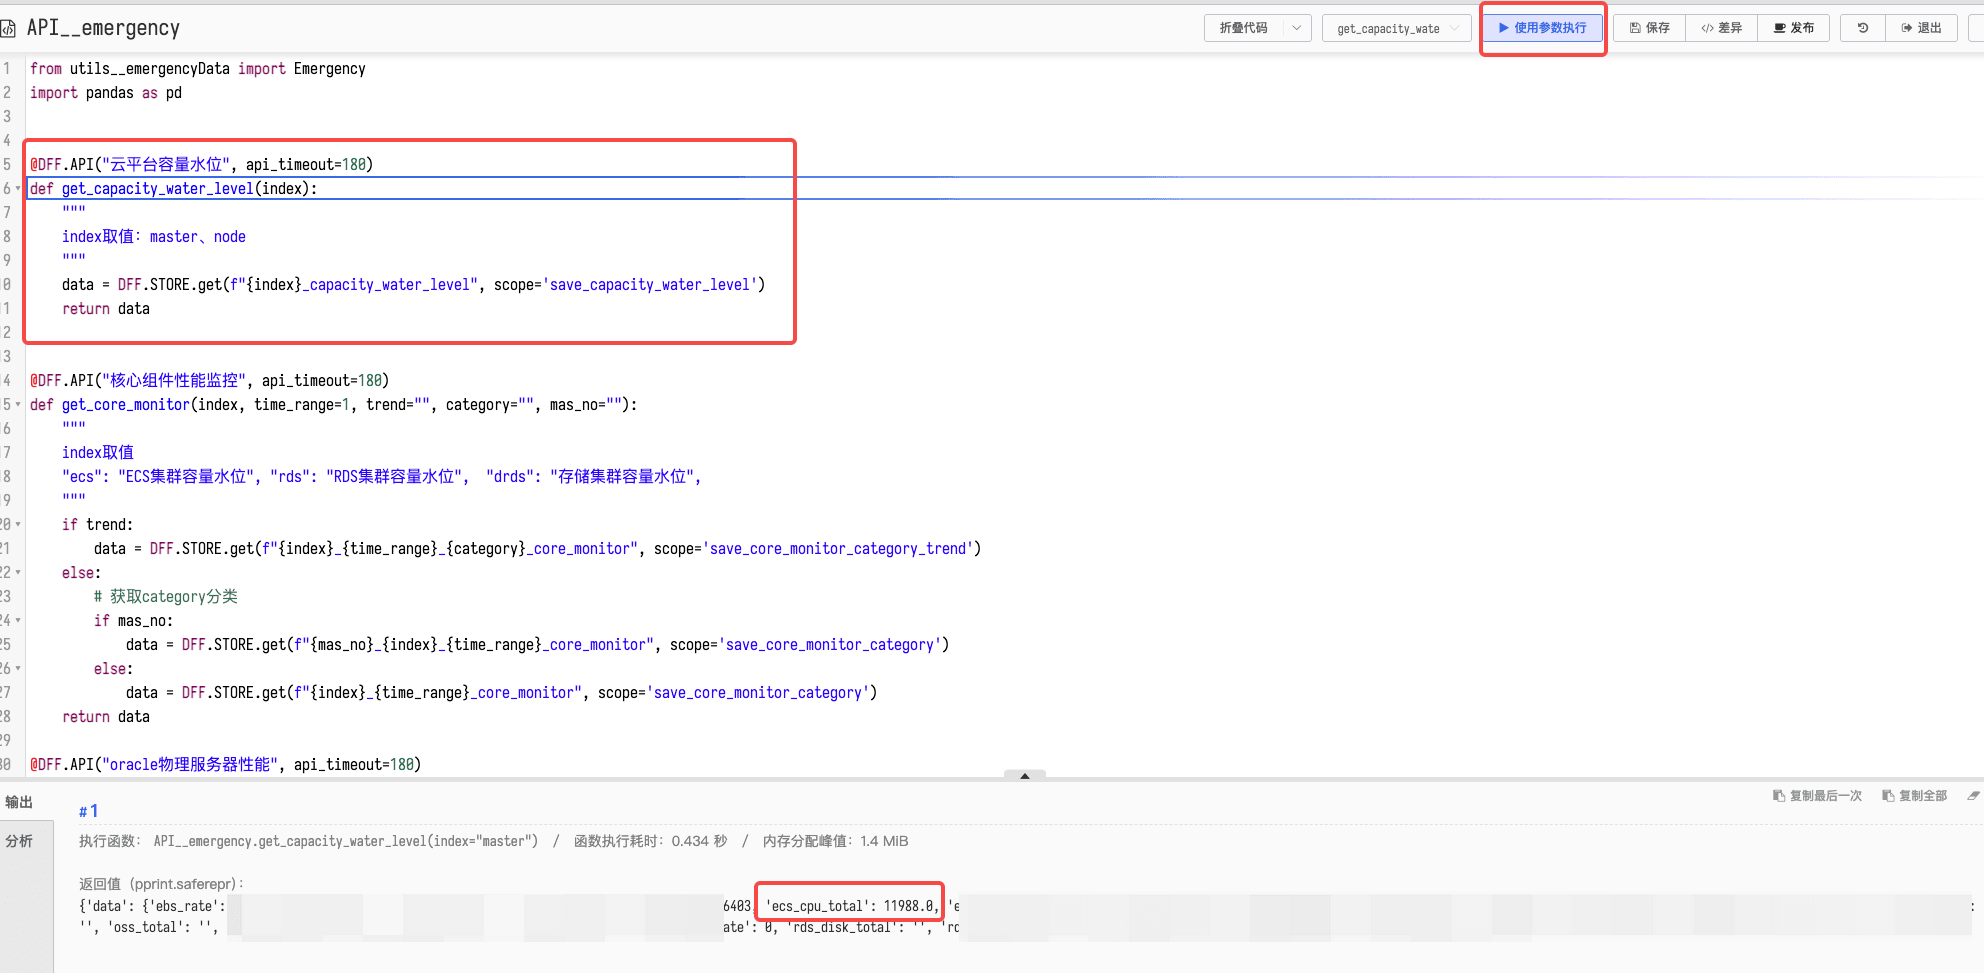
入口函数及 CPU 总量返回值核对
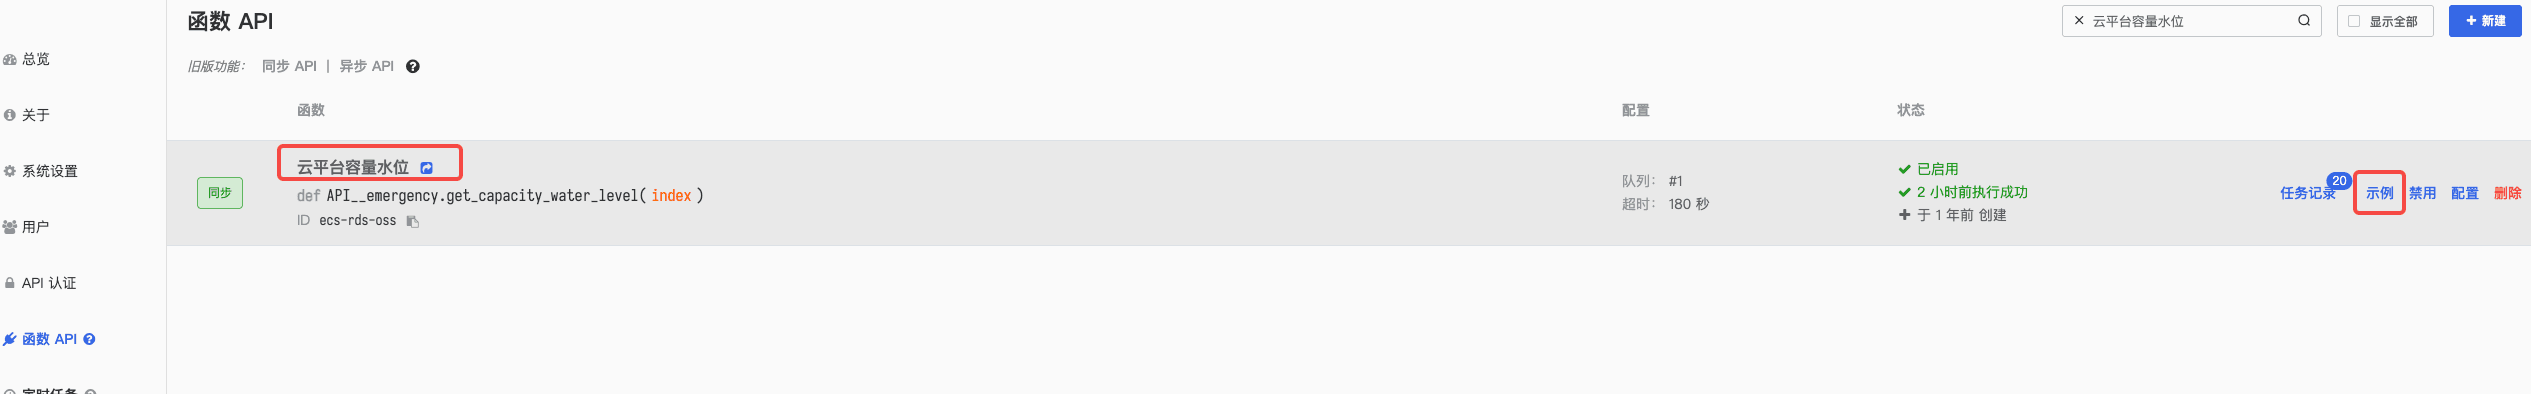
容量水位 API 与调用示例
将接口绑定到大屏组件
最后,把指标名称、对应 API、请求参数与返回字段补充到指标表中。大屏端依据这些约定调用容量水位接口,传入对应的 index 参数,再把接口返回的 CPU 总量字段绑定到相应组件。下图展示的是 Func 生成的接口调用参数和地址,可作为大屏对接的依据。
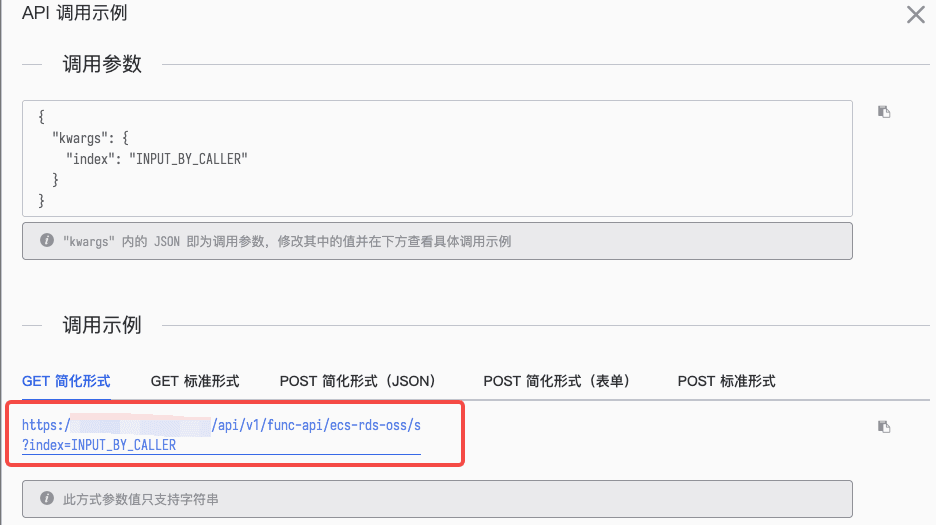
容量水位接口调用参数与地址
至此,CPU 总量已经贯通观测云查询、Func 加工与缓存、函数 API 和大屏组件。新增其他指标时,可以沿用公共查询函数、缓存机制和接口规范,补充相应的查询语句、处理逻辑与字段映射。只要接口约定保持稳定,页面布局和展示形式便可以独立调整;指标口径变化也可以优先在 Func 中维护。
实践效果
下图为某业务专题大屏的展示效果。Func 将观测数据整理为统一的接口结果,大屏通过地图与统计图表呈现不同地区的数据分布。
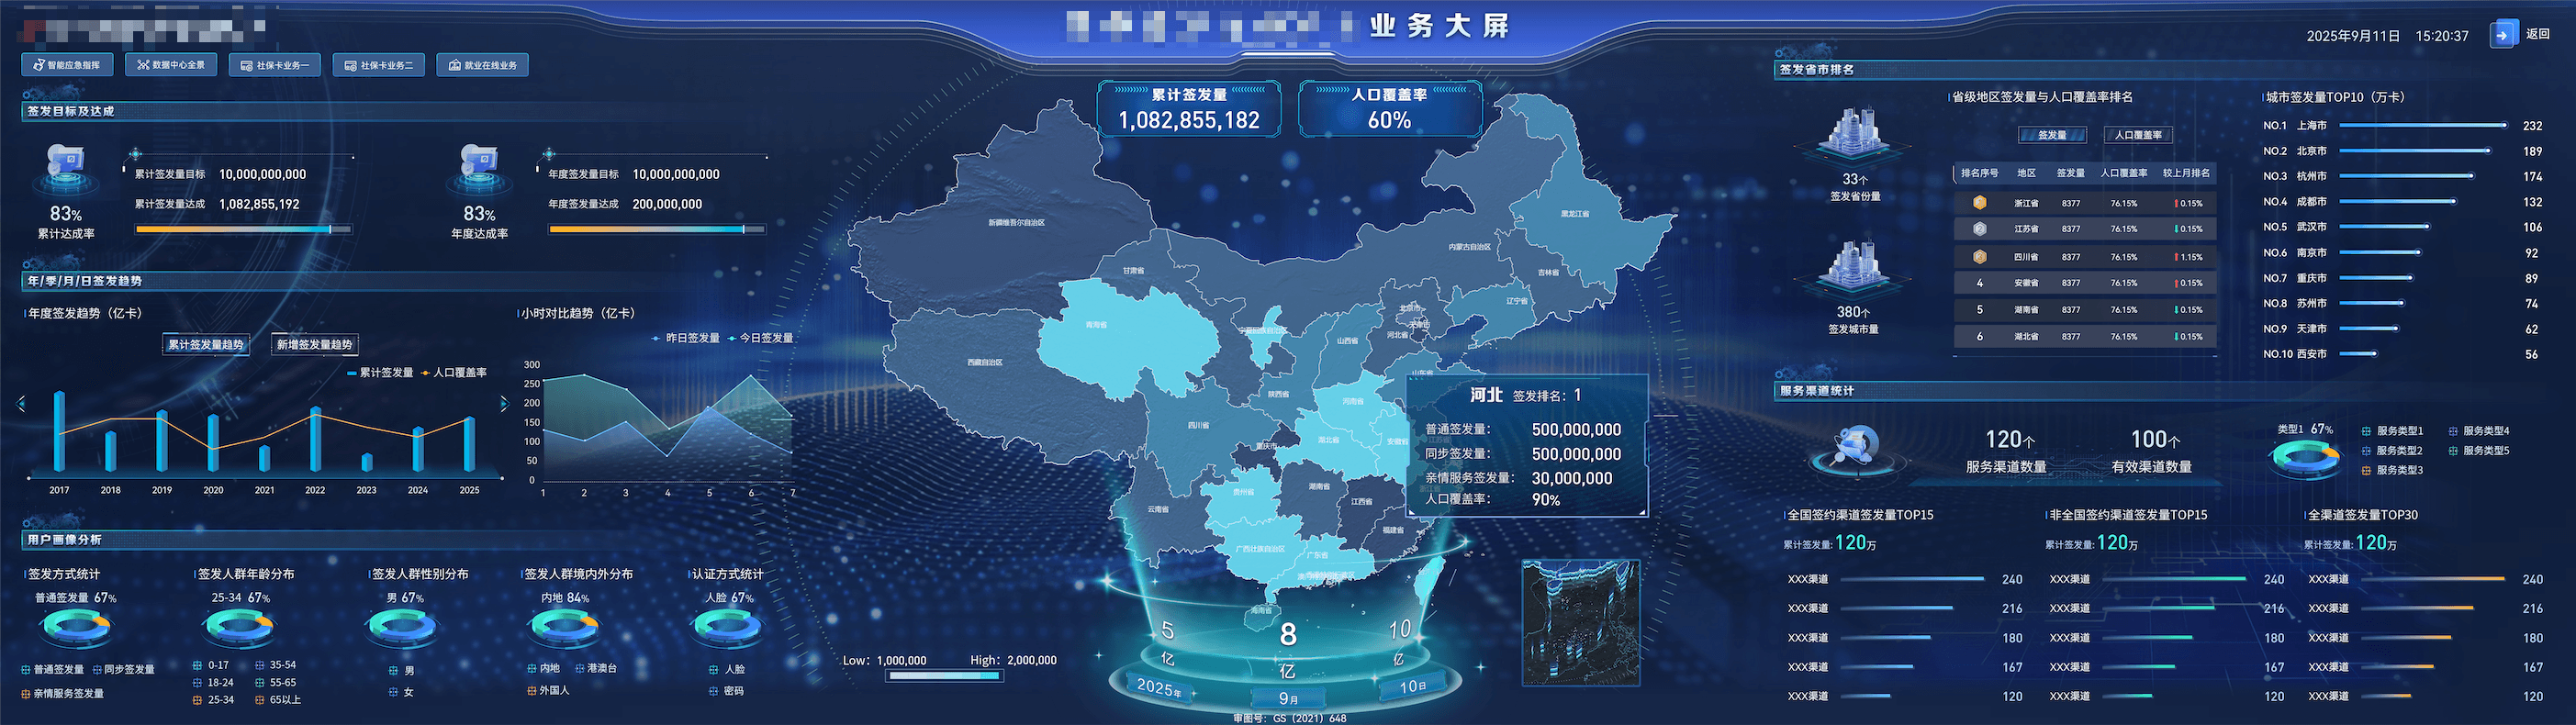
某业务专题大屏可视化效果图
目前,Func 已从观测云获取 200+ 指标数据,并通过查询封装、指标加工与接口发布,形成 200+ 数据接口,为多个大屏项目提供数据服务。处理的数据覆盖多个行业,应用场景包括金融行情交易、数据中心运维、业务系统监控、应急指挥等。从指标查询、加工与定时缓存到接口调用,整套流程已能够稳定运行。
这些实践沉淀了可复用的连接配置、公共查询逻辑、指标处理方法、缓存机制和接口规范。Func 将这些能力集中维护,供不同项目按需调用和组合;同一指标服务可支撑多个页面,新增业务需求可在已有能力上补充,减少重复开发,并保持指标口径与接口返回的一致性。
总结
这套实践以 Func 为核心,将观测云查询、指标加工、定时缓存和接口服务组织为可复用的数据处理流程,并通过指标表连接数据服务与大屏展示。其价值在于同一套流程能够服务不同专题和项目,已有的查询逻辑、处理方法与接口约定可以持续复用,减少重复开发和后续维护成本。