被低估的 Profiling:从资源异常,一路找到代码热点
Profiling 能帮助开发者从 CPU、内存、GC 等资源异常出发,通过火焰图与调用链分析,精准定位代码热点和对象分配来源。结合观测云关联指标、Trace 与 Profile,形成从问题发现、代码优化到效果验证的完整闭环,提升性能排查与优化效率。
你可能遇到过这样的排查场景:压测一上来,接口延迟开始增加,GC 次数也跟着上涨。打开监控,CPU 没有跑满,堆内存仍在上下波动,调用链里却很难找到一个足够突出的慢调用。
继续翻代码,似乎哪里都可以优化。字符串处理可以少一点,集合可以提前分配容量,缓存也许还能再加一层。真正需要判断的是:哪些操作贡献了主要消耗,应该优先修改哪条业务路径。
Profiling 的价值就在这里:记录应用运行时的调用栈,让计算热点、等待路径和对象分配来源变得可见。它可以把“资源发生了异常”继续推进到“哪些代码值得检查”。
如果排查一直停留在资源曲线和调用链,方法级的证据就容易被忽略。接下来通过观测云 Java Profiling 的采集配置与实际案例,建立从异常窗口、代码热点到优化验收的一条完整路径。
重新认识 Profiling 的价值
JDK Flight Recorder(JFR)是 JDK 内置的事件记录与性能诊断框架。Oracle Java 团队近年持续通过官方文档、技术分享和 JDK 功能演进介绍它的应用价值,关注点已经覆盖持续观测、性能分析和生产排障。
2026 年 8 月 11 日,Oracle Java 团队的 Inside Java 发布了 Mikael Vidstedt 的专题分享《The Power of JDK Flight Recorder》,将 JFR 介绍为轻量、可持续运行的观测能力,并展示性能瓶颈、内存泄漏和线程问题的分析方法。这为在生产问题发生前保留运行时证据、发生后追溯原因提供了官方实践参考。
在演讲中,他用“时光机”来形容持续保留运行时证据的价值:
“It's a time machine that allows you to go back and see what led up to that and what else happened at the same time.” “它就像一台时光机,让你回到过去,看到问题发生之前的过程,以及同一时间还发生了什么。”
——Mikael Vidstedt
2026 年 9 月 15 日,Oracle 在JDK 27 发布说明中介绍了 JEP 536:JFR 进程内数据脱敏,使录制中的命令行参数、环境变量初始值和系统属性初始值能够在离开进程前被脱敏。JFR 仍在围绕实际诊断与运维需求持续增强。
在采集策略上,Oracle 的JDK 26 故障排查指南区分了适合持续录制的低开销 default 模板,以及提供更多诊断信息、同时开销更高的 profile 模板。落地时,应按诊断目标选择事件和配置,再评估业务负载下的实际影响。
JFR 的官方实践支持使用运行时事件进行 Java 性能诊断。下面的案例使用 JDK 21 和 ddprof 采集引擎,通过 JFR 记录承载采样数据,再在观测云中分析调用路径。JDK 原生 JFR 事件与 ddprof 扩展事件需要按各自语义解读,较新 JDK 的增强能力也应以实际运行版本为准。
从资源异常选择分析维度
“服务有点慢”包含太多可能。把它改写成“相同请求量下,订单接口的 P99 增加,同时 GC 暂停变长”,排查就有了起点:先对齐时间,再观察分配压力、GC 和请求耗时之间的关系。
这里的关键是缩小范围。确定服务、环境、发布版本和异常实例后,选择与问题对应的 Profile 维度。一次分析先回答一个明确问题,更容易形成能够验证的判断。
| 业务现象 | 优先分析维度 | 配合观察 |
|---|---|---|
| CPU 持续升高 | CPU Time | 请求量、进程 CPU、容器限流 |
| 接口变慢,CPU 不高 | Wall Time | Trace、锁等待、线程状态 |
| 分配速率升高,GC 频繁 | Allocated Memory、Allocations | GC 暂停、分配速率 |
| 内存占用持续增长 | Live Heap | GC 后堆占用、对象引用关系 |
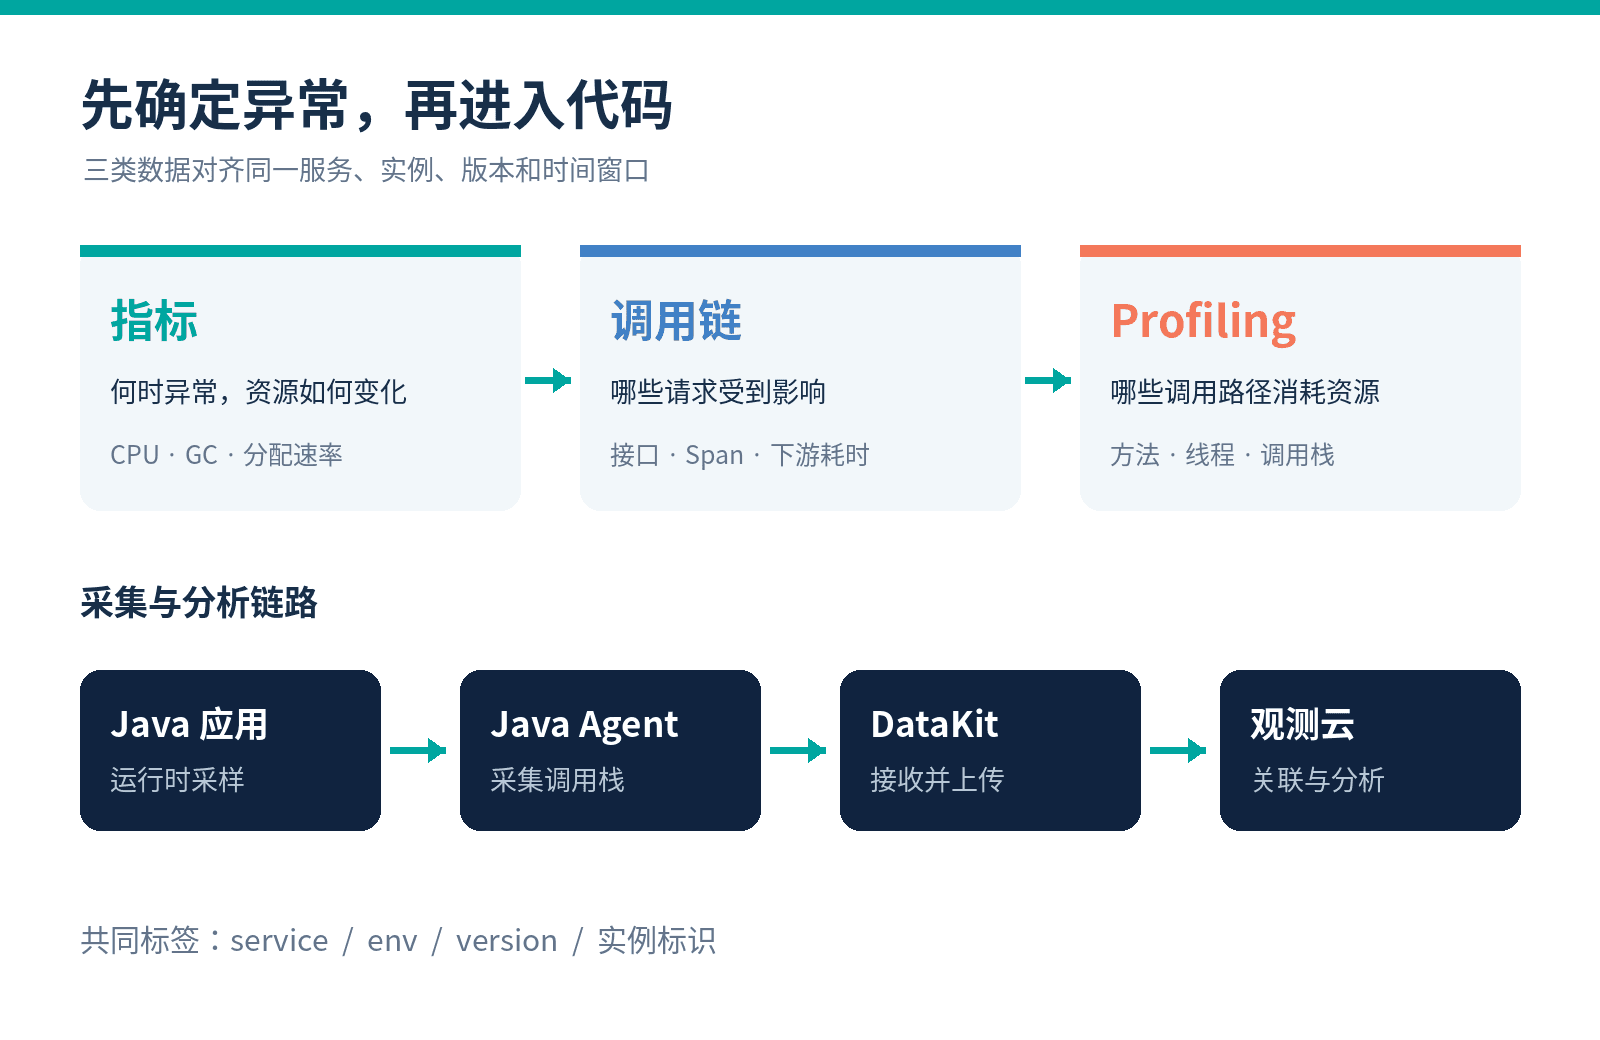
指标、调用链和 Profiling 各有侧重。指标帮助找到异常时间,调用链帮助确认受影响的请求,Profiling 进一步展示执行路径上的资源消耗。把三者放在相同的服务、实例和时间窗口里,证据才容易连接起来。
接入采集,让数据能够关联
在观测云中,可以通过 DataKit 接收 Java Profiling 数据。接入前应确认 JDK、操作系统和 Agent 版本的兼容范围;接入后需要通过启动日志和实际收到的数据,确认预期采集能力已经生效。
应用标识建议与 APM 保持一致:service 对应服务,env 区分环境,version 记录发布版本。多实例部署还需要保留主机或容器标识。版本发布后出现异常时,这些信息能帮助快速区分新旧版本,以及正常与异常实例。
下面的配置适用于 Linux、JDK 21 及支持相关能力的观测云 Java Agent,展示 CPU、Wall 和分配分析的接入方式。示例中 DataKit 与应用部署在同一主机,地址和路径需替换为实际值。
java \
  -javaagent:/opt/agent/dd-java-agent.jar \
  -Ddd.agent.host=127.0.0.1 \
  -Ddd.trace.agent.port=9529 \
  -Ddd.service=order-service \
  -Ddd.env=test \
  -Ddd.version=1.2.3 \
  -Ddd.profiling.enabled=true \
  -Ddd.profiling.ddprof.enabled=true \
  -Ddd.profiling.ddprof.cpu.enabled=true \
  -Ddd.profiling.ddprof.wall.enabled=true \
  -Ddd.profiling.ddprof.alloc.enabled=true \
  -jar application.jar
DataKit 需要启用 Profile 采集器,并确认应用到采集器的连接正常。具体接入配置及兼容范围见文末官方文档。
生产环境可以先选择少量实例,在相近负载下比较 CPU、RSS、吞吐量、P95/P99 和 GC 暂停,再逐步推广。采集开销与应用行为、事件类型和配置有关,应以业务实测为依据。
采集窗口也要覆盖问题。稳定压测可以先观察连续数分钟内的多个分片,确认热点是否重复出现;低频任务需要覆盖完整执行周期。启动预热与稳定运行阶段分别分析,可以减少类加载、JIT 编译等行为对判断的干扰。
读懂火焰图,追踪业务调用路径
第一次打开火焰图,很容易被大量方法名吸引。真正开始分析之前,先看清当前维度:CPU、Wall、分配字节数和分配次数回答的问题各不相同,同一个方法的占比也可能完全不同。
普通聚合火焰图中,宽度反映所选指标的累计权重,纵向展示调用层级,横向位置通常不代表时间先后。某个方法很宽,说明它及相关调用路径值得关注,随后还需要结合调用入口解释这部分消耗。
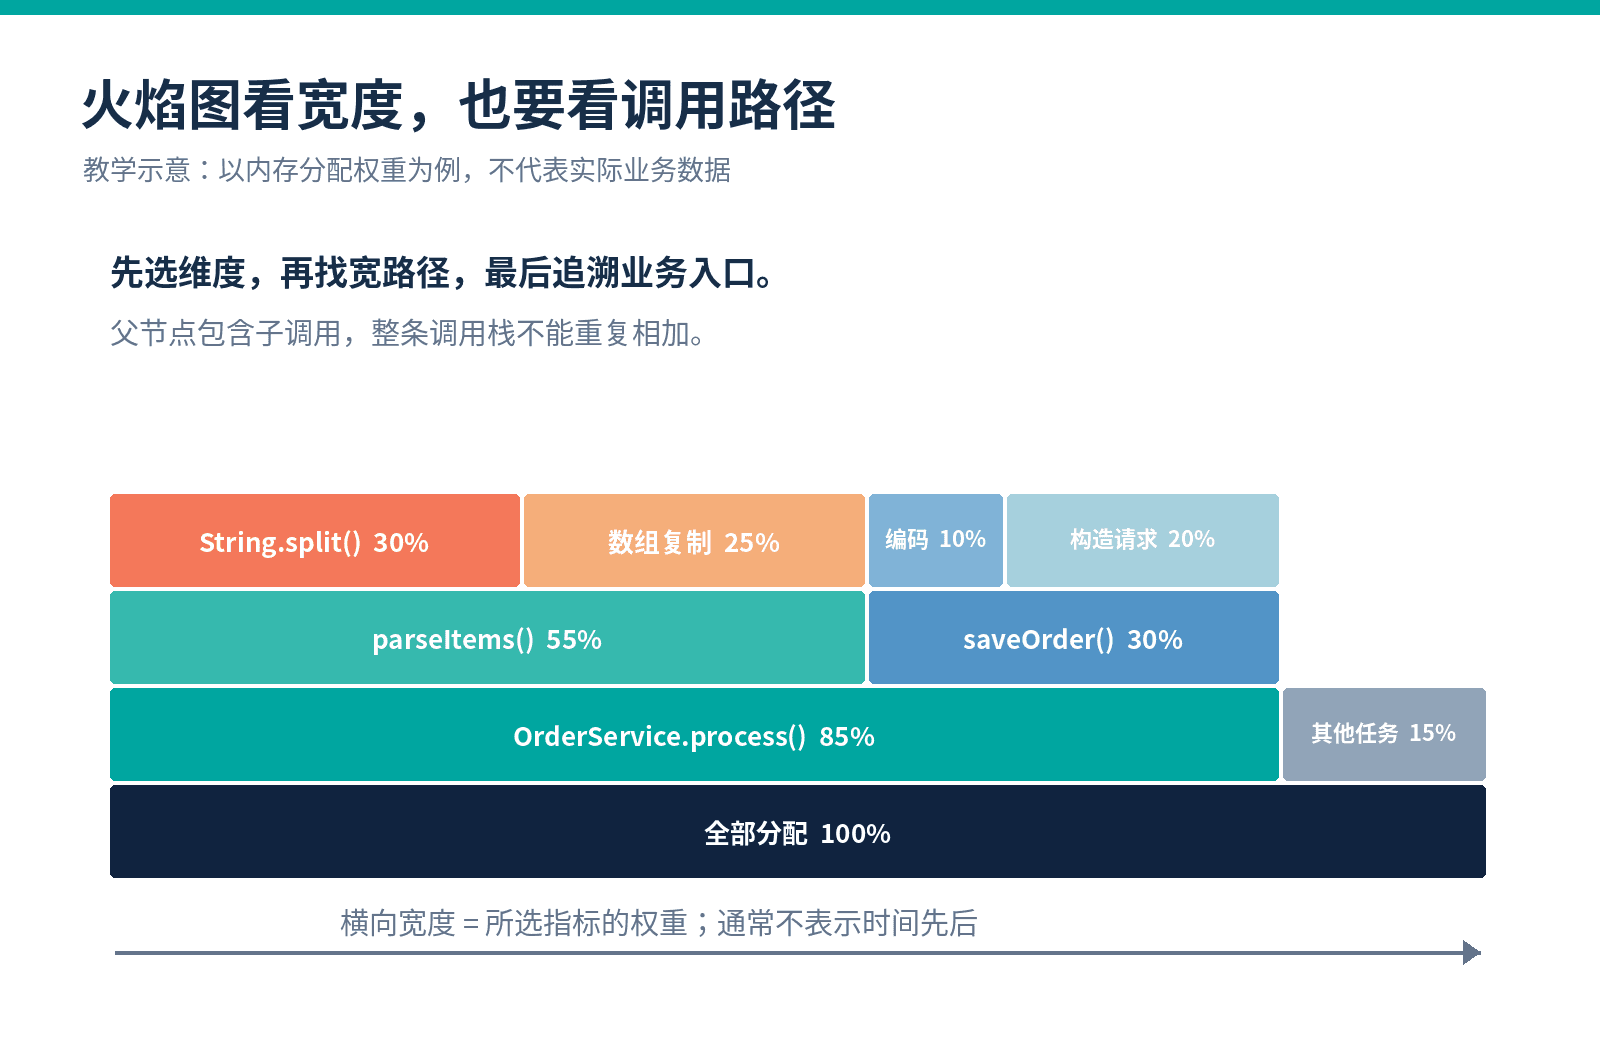
例如 String.split() 的分配量较高,可以沿调用栈继续查看:是哪个接口调用它,是否位于循环中,同一份数据是否被反复拆分,业务最终又使用了多少拆分结果。沿着这些线索回到源码,优化目标会具体得多。
读取累计值时也要留意层级关系。父方法的数值通常已经包含子调用,整条调用栈不能重复相加;多线程聚合的时间也需要结合线程范围解释,不能直接当成一个请求的端到端耗时。
如果已经定位到某个慢请求,可以结合 Trace 进入关联 Profile,继续观察对应的执行路径。这样能够减少全局热点的干扰,让分析保持在受影响的业务范围内。
切换分析维度后,同一个方法会呈现不同侧面。示例的 Wall Time 视图汇总值为 24.65 s,HashMap.resize() 为 2.30 s;而在分配视图中,它的分配字节占比约为 4.41%。这两个数分别描述时间和分配,不能相互替代。
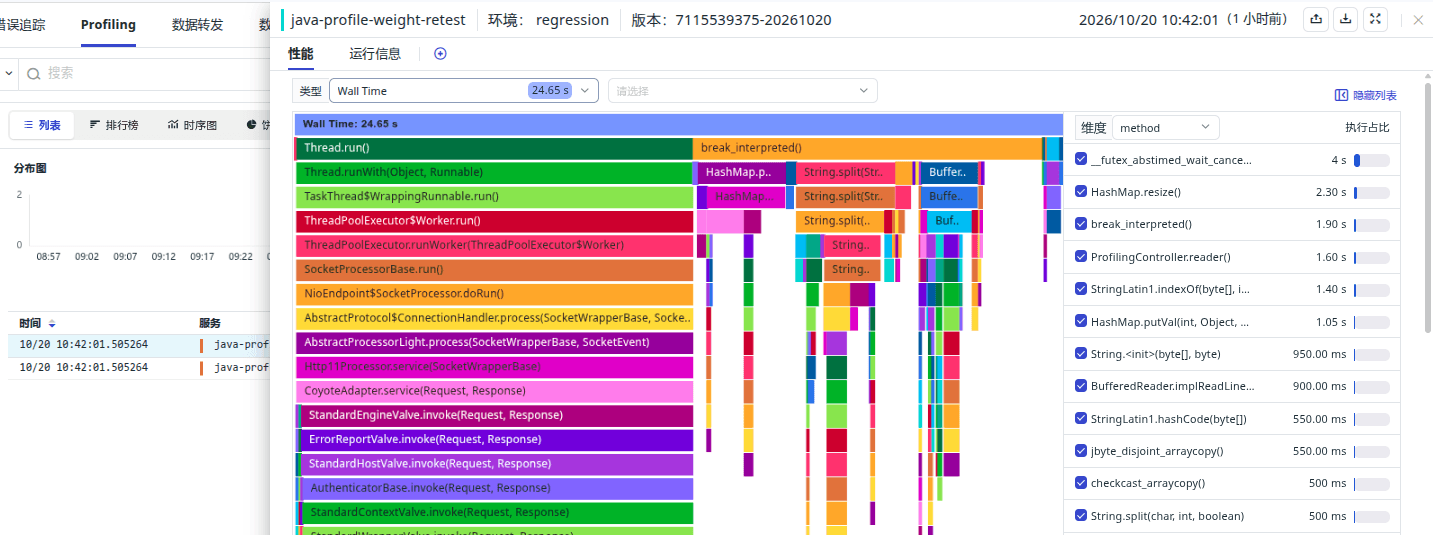
时间排行里还出现了 futex 等底层等待符号。可以结合线程角色、业务调用栈和 Trace 继续判断等待是否合理。这里的聚合值不能直接当作一次接口调用的响应时间,也不能仅凭某个等待符号确认瓶颈。
从内存分配案例看懂采样与热点
一个最大堆为 2 GiB 的应用,一分钟内累计分配十几 GiB 内存,是可能发生的。对象经历创建、使用和回收,堆空间反复复用;当前堆占用保持波动,并不意味着分配压力很小。
Allocated Memory 表示采集期间累计分配的堆内存,包含随后被回收的对象;Allocations 表示分配次数;Live Heap 则关注尚未被回收的对象。理解这些差异,才能选择合适的优化方向。
高分配量、稳定的 GC 后堆占用,通常提示需要调查临时对象和分配压力。如果相近负载下 GC 后堆占用持续增长,则应进一步检查对象保留、缓存规模和引用关系。单张分配火焰图不足以确认内存泄漏。
另一个值得注意的细节是采样权重。它会直接影响分配总量,也会影响方法排行。
一组真实 Java 分配采样包含 5,238 条 datadog.ObjectSample 事件。直接累计样本对象的 size,结果约为 509.31 MiB;根据 weight 加权还原后,估算分配量约为 11.47 GiB。两种结果相差约 23 倍。
在这类事件中,size 表示被采样对象的大小,weight 用于估算该样本代表的分配规模。对应的统计口径如下;其他事件类型应分别确认字段语义。
分配字节数 = Σ(size × weight)
分配次数   = Σ(weight)
如果忽略权重,大量小对象的贡献可能被低估,方法占比也会失真。将权重正确应用后,字符串拆分、数组复制和集合增长等分配来源会变得更清晰。
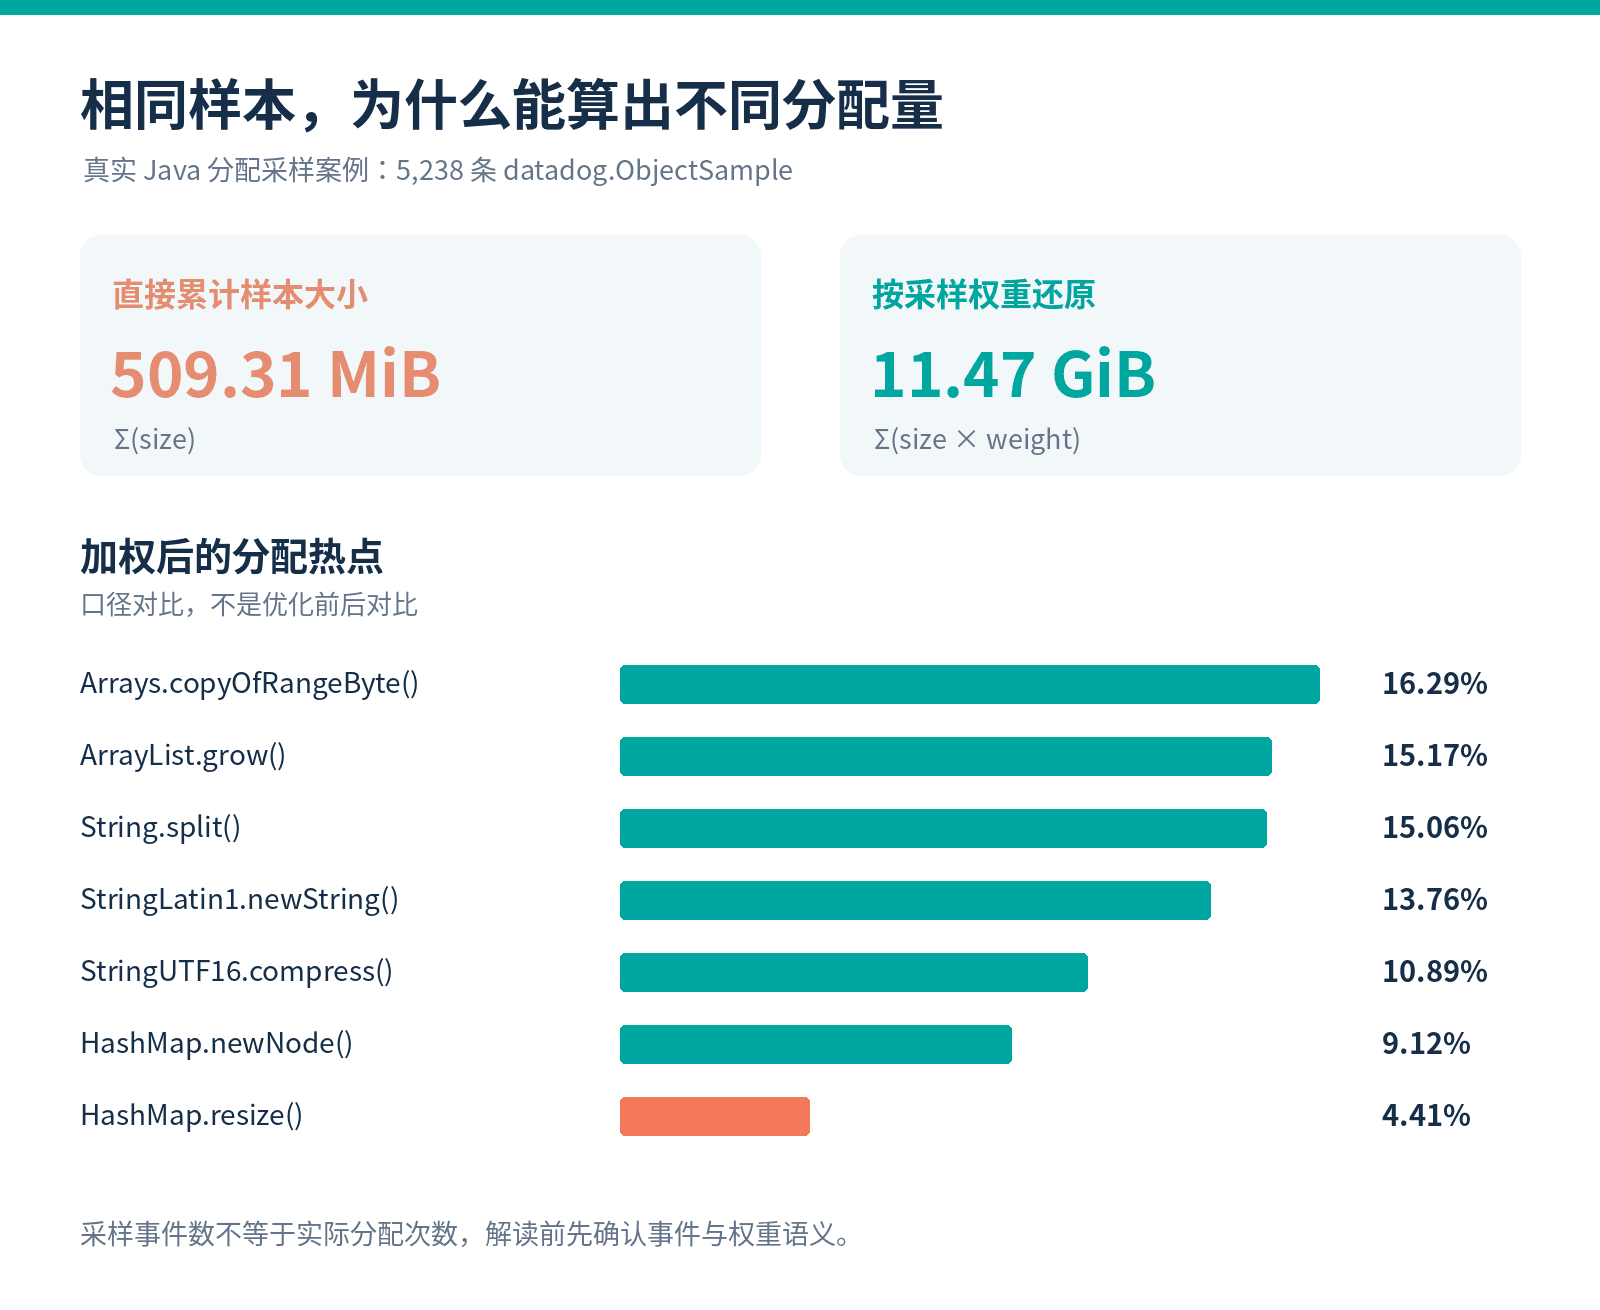
这组数据中,Arrays.copyOfRangeByte()、ArrayList.grow() 和 String.split() 分别贡献约 16.29%、15.17% 和 15.06% 的分配量,HashMap.resize() 的占比约为 4.41%。这些结果把后续调查集中到了具体调用路径。
沿着实际分配调用栈向业务代码继续追踪,可以看到 ProfilingController.mapReader()、reader(),以及下层的 String.split()、字符串构造和数组复制等路径。方法排行帮助找到值得关注的操作,调用栈则把它们与具体业务入口连接起来。
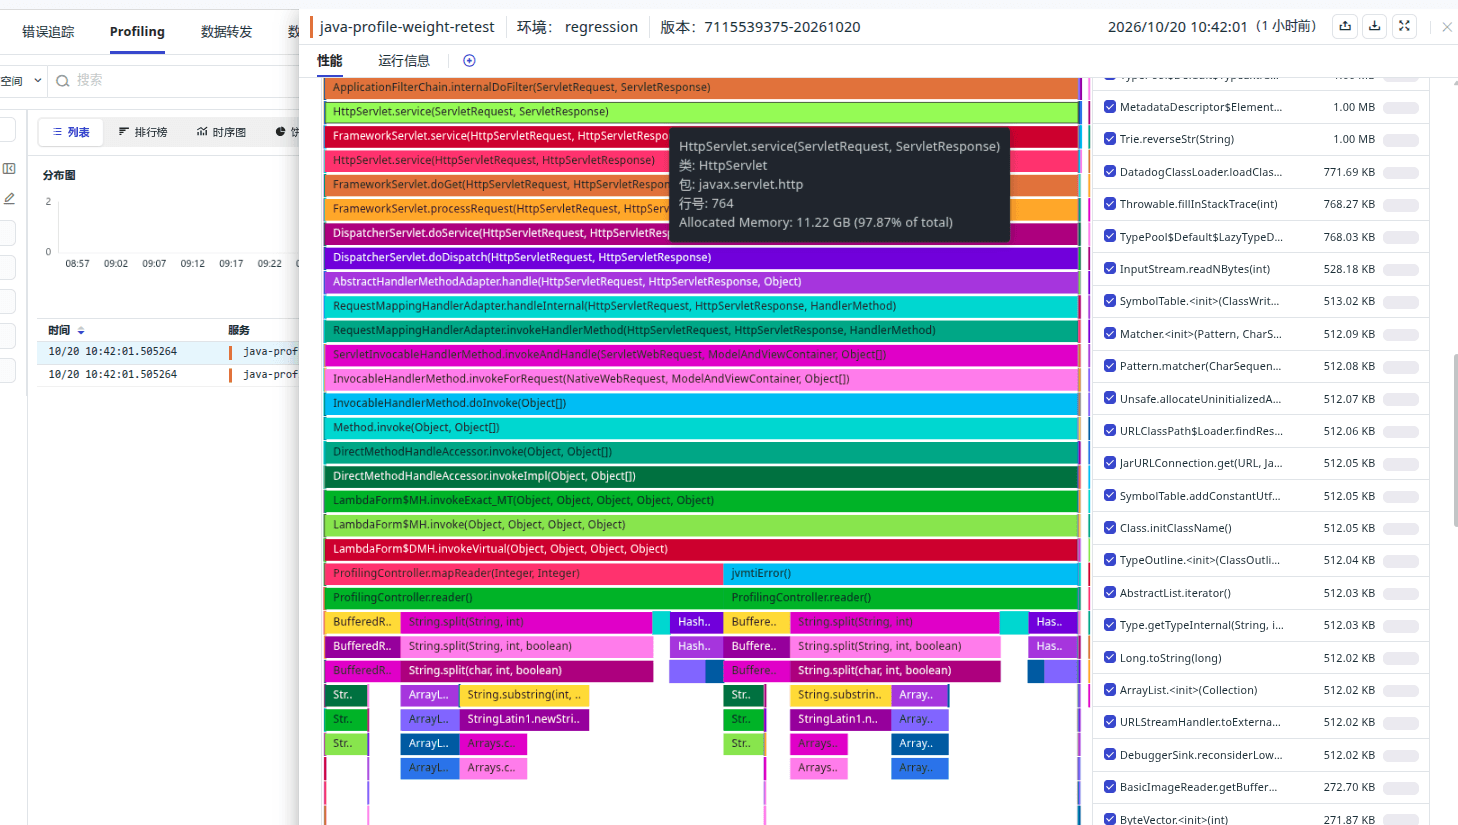
图中悬浮提示显示,HttpServlet.service() 这条调用路径累计关联约 11.22 GB 分配,占总量的 97.87%。这是包含下层调用的累计值,不能据此认定 Servlet 方法自身分配了全部内存。继续追踪到业务方法及其下层分配操作,才更容易找到可以修改的代码位置。
接下来可以检查容量可预测的集合是否存在反复扩容,同一输入是否被重复解析,以及批量处理过程中是否保留了多份中间字符串和数组。是否修改、如何修改,还要结合调用频率和业务语义决定。
尤其需要避免为了减少分配而引入更复杂的长期缓存。分配下降与内存保留增加可能同时发生,评价优化时应把这两方面放在一起看。
核对统计口径,避免热点误判
如果运行指标显示明显的分配压力,Profile 详情却只有很小的数值,可以先检查时间窗口、实例、单位、过滤条件、采集引擎和聚合口径。完成这些核对,再决定是否需要修改业务代码。
对于同一份 Profile,详情汇总、方法排行和火焰图根节点应使用一致的口径。结合运行指标比较时,也应尽量对齐同一进程、分片和事件集合。独立采集的数据可能存在采样差异,判断前需要确认各自的统计含义。
这组样本按采样权重聚合后,Profile 详情汇总与火焰图根节点均为 12,313,895,850 B,约 11.47 GiB;分配次数约为 395,690,774。它们与原始采样的加权计算结果一致,仅存在整数取整差异。原始采样事件为 5,238 条,需要与加权估算的分配次数区分。
这种核对让热点分析有了可靠基础,也能避免把采样事件数直接理解为应用真实分配次数。
验证优化收益,形成分析闭环
找到热点只是起点。修改代码后,如果请求量、数据规模或实例资源发生变化,资源曲线的升降就难以归因。对照测试应尽量保持请求模型、并发数、JDK、JVM 参数和实例资源一致,并单独处理预热阶段。
当吞吐量存在差异时,可以增加按成功请求数归一化的观察值,辅助比较分配效率:
平均每次成功请求分配量
= 同期累计分配字节数 ÷ 同期成功请求数
该值可能包含后台任务的分配,适合相近工作负载下的整体比较。需要分析单个接口时,还应进一步缩小调用路径或关联请求范围。
验收时,建议同时回答以下问题:
- 相同业务量下,CPU 或每次请求的分配量是否下降?
- P95/P99、吞吐量和 GC 暂停是否出现符合预期的变化?
- 错误率、超时率以及业务结果是否保持合理?
- 热点的绝对消耗和调用路径变化,能否由代码修改解释?
仅看占比容易产生误判。一个方法占比下降,可能来自自身消耗减少,也可能来自其他方法消耗增加。将绝对值、单位业务量消耗和用户体验放在一起,才能判断修改是否值得保留。
让 Profiling 进入日常排查,可以从一个高频接口或关键任务开始:先保留稳定负载下的基线,再观察异常窗口中的调用路径,最后用同样的业务量验证修改效果。记录每次分析使用的版本、负载条件和 Profile,下一次性能变化就有了可以比较的起点。
Profiling 值得被重新认识的地方,是它能让资源曲线背后的代码行为变得可见。把这份证据与指标、调用链连接起来,优化就有了更明确的落点:哪条路径消耗了资源,哪项修改值得保留,以及业务最终获得了什么改善。
参考资料