Moquette 可观测性最佳实践
Moquette 介绍
Moquette 是使用 Java 实现的轻量级 MQTT Broker,可独立部署,也可嵌入应用中,为设备、服务和业务系统提供发布与订阅通信。它支持 QoS 0、QoS 1 和 QoS 2,适合物联网设备接入、边缘消息转发及应用内消息通信等场景。
在实际运行中,消息发布量增加、订阅端处理速度下降或 JVM 资源紧张,都可能影响消息处理。仅观察 Broker 进程是否存活,难以判断问题发生在消息入口、内部事件处理还是 JVM 层面。将会话、消息、队列与 JVM 指标放在同一时间轴上,有助于发现负载变化,判断队列压力,并进一步定位内存、GC 和线程异常。
观测云
观测云是一款专为IT工程师打造的全链路可观测产品,它集成了基础设施监控、应用程序性能监控和日志管理,为整个技术栈提供实时可观察性。这款产品能够帮助工程师全面了解端到端的用户体验追踪,了解应用内函数的每一次调用,以及全面监控云时代的基础设施。此外,观测云还具备快速发现系统安全风险的能力,为数字化时代提供安全保障。
采集器配置
采集链路为:Moquette 暴露 /metrics → DataKit 的 Prom 采集器定时抓取 → 写入观测云 moquette 指标集 → 在仪表板与监控器中查询。
指标采集
**1. 开启 Moquette 的 Prometheus 指标。**确认部署包包含 metrics_prometheus 模块及其依赖,并在 Broker 启动时可加载。在 moquette.conf 中加入以下配置,然后按部署方式重启 Moquette:
metrics_provider_class MetricsProviderPrometheus
metrics_endpoint_port 9400
**2. 确认采集地址。**DataKit 应能访问 http://<broker-host>:9400/metrics。主机部署使用可达的主机地址;容器部署使用容器网络内可解析的服务名,或正确映射后的主机地址。截图中的 moquette-local:9400 是示例环境的指标端点,需要替换成实际地址。
**3. 安装并配置 DataKit。**在观测云控制台获取对应工作空间的 DataKit 安装指引,完成安装后进入 DataKit 安装目录,复制 Prom 采集器配置:
mkdir -p conf.d/prom
cp conf.d/samples/prom.conf.sample conf.d/prom/moquette.conf
将 conf.d/prom/moquette.conf 配置为以下内容,并替换 Broker 地址、环境与部署名称:
[[inputs.prom]]
  urls = ["http://<broker-host>:9400/metrics"]
  source = "moquette"
  interval = "15s"
  timeout = "10s"
  measurement_name = "moquette"
  keep_exist_metric_name = true
  election = false

  [inputs.prom.tags]
    service = "moquette"
    env = "<env>"
    deployment = "<deployment-name>"
**4. 重启 DataKit 并查看数据。**主机安装可执行:
datakit service -R
关键指标
本次集成的指标集为 moquette。下表列出日常排查常用的关键指标;
| 指标名称 | 描述与使用方式 | 单位 |
|---|---|---|
moquette_open_sessions |
Broker 中的会话数量,用于观察会话规模及变化。 | 个 |
moquette_publishes_total |
累计发布消息数;计算每秒速率后观察发布负载。 | 条;速率为条/秒 |
moquette_session_messages_total |
按 QoS 和会话事件队列统计的累计消息分发数。 | 条;速率为条/秒 |
moquette_session_queue_fill |
内部会话事件队列当前占用比例,原始值范围为 0–1。 | 比例;展示为 % |
moquette_session_queue_fill_max |
上次抓取以来的队列最大占用比例,适合发现采样间隔内的短时压力。 | 比例;展示为 % |
moquette_session_queue_overruns_total |
队列已满导致的累计任务入队失败次数,应关注窗口内新增次数。 | 次 |
jvm_memory_used_bytes jvm_memory_max_bytes |
JVM 内存区域已用量与最大容量;按 area 区分 heap、nonheap。仅在最大容量大于 0 时计算使用率。 | B |
jvm_memory_pool_used_bytes |
按 pool 区分内存池的已用量,用于分析内存增长位置。 | B |
jvm_memory_pool_allocated_bytes_total |
内存池累计分配量,仅在 GC 后更新;速率反映该统计口径下的分配变化。 | B;速率为 B/s |
jvm_gc_collection_seconds_count jvm_gc_collection_seconds_sum |
GC 累计次数与累计耗时,分别计算速率后观察回收频率与时间消耗。 | 次、s |
jvm_threads_current jvm_threads_state |
当前线程数量及按 state 分组的线程数量。 | 个 |
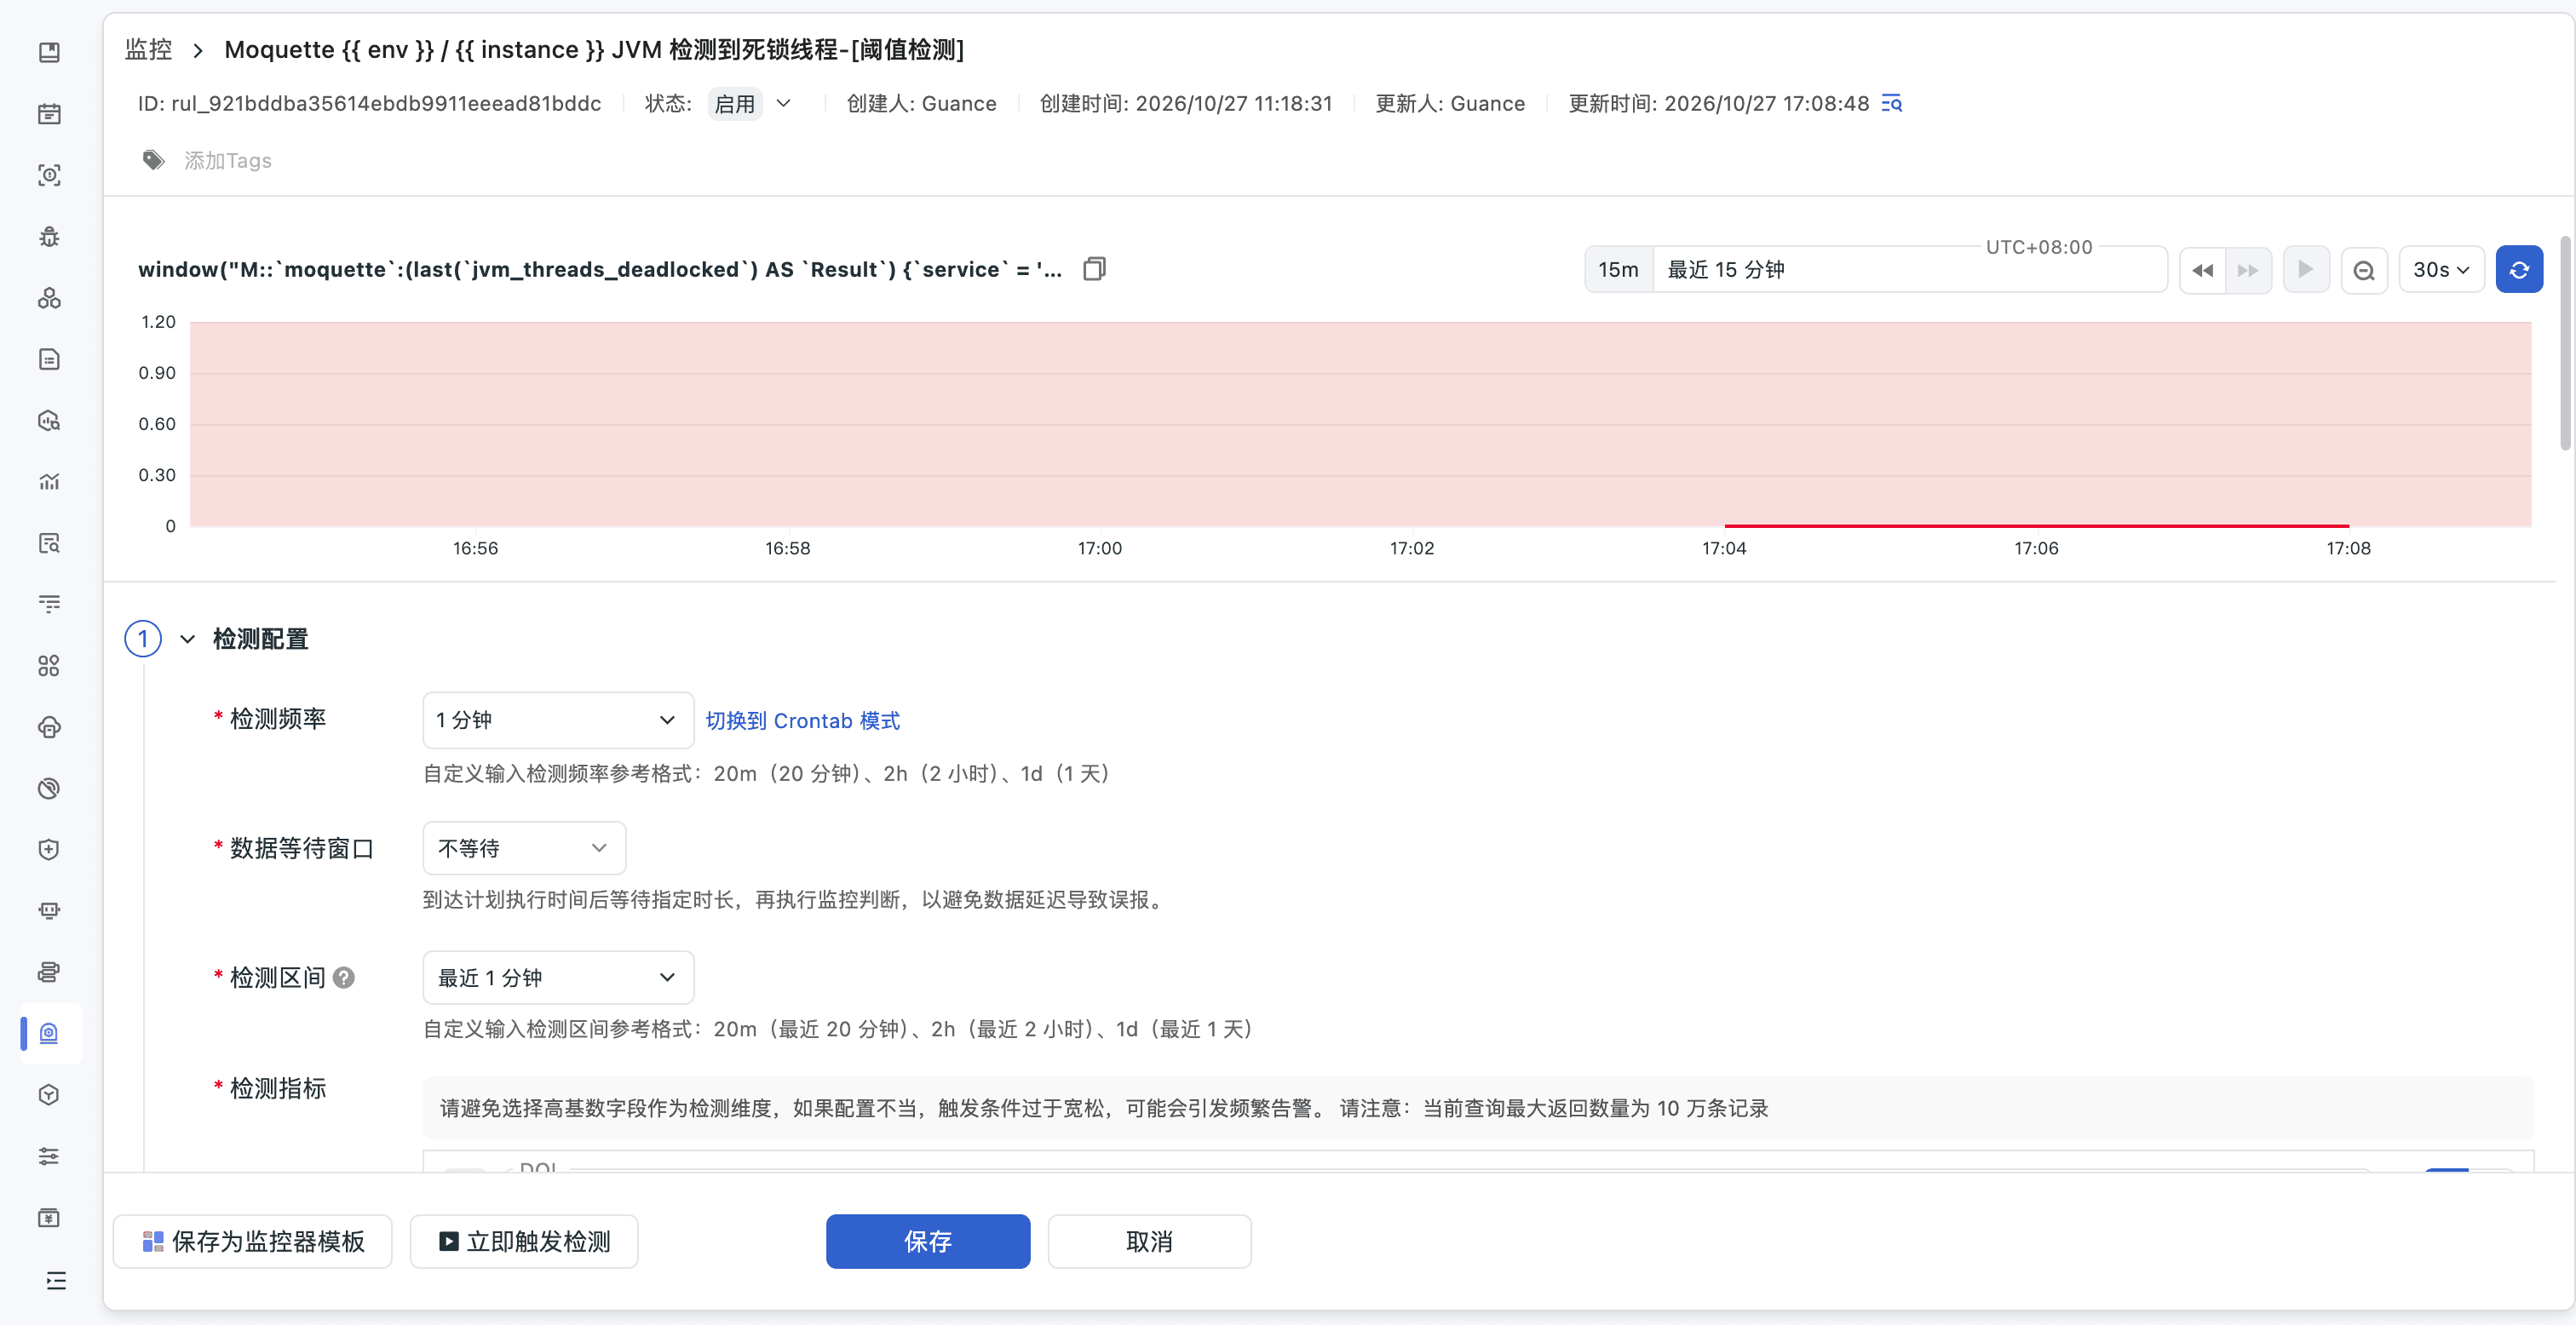
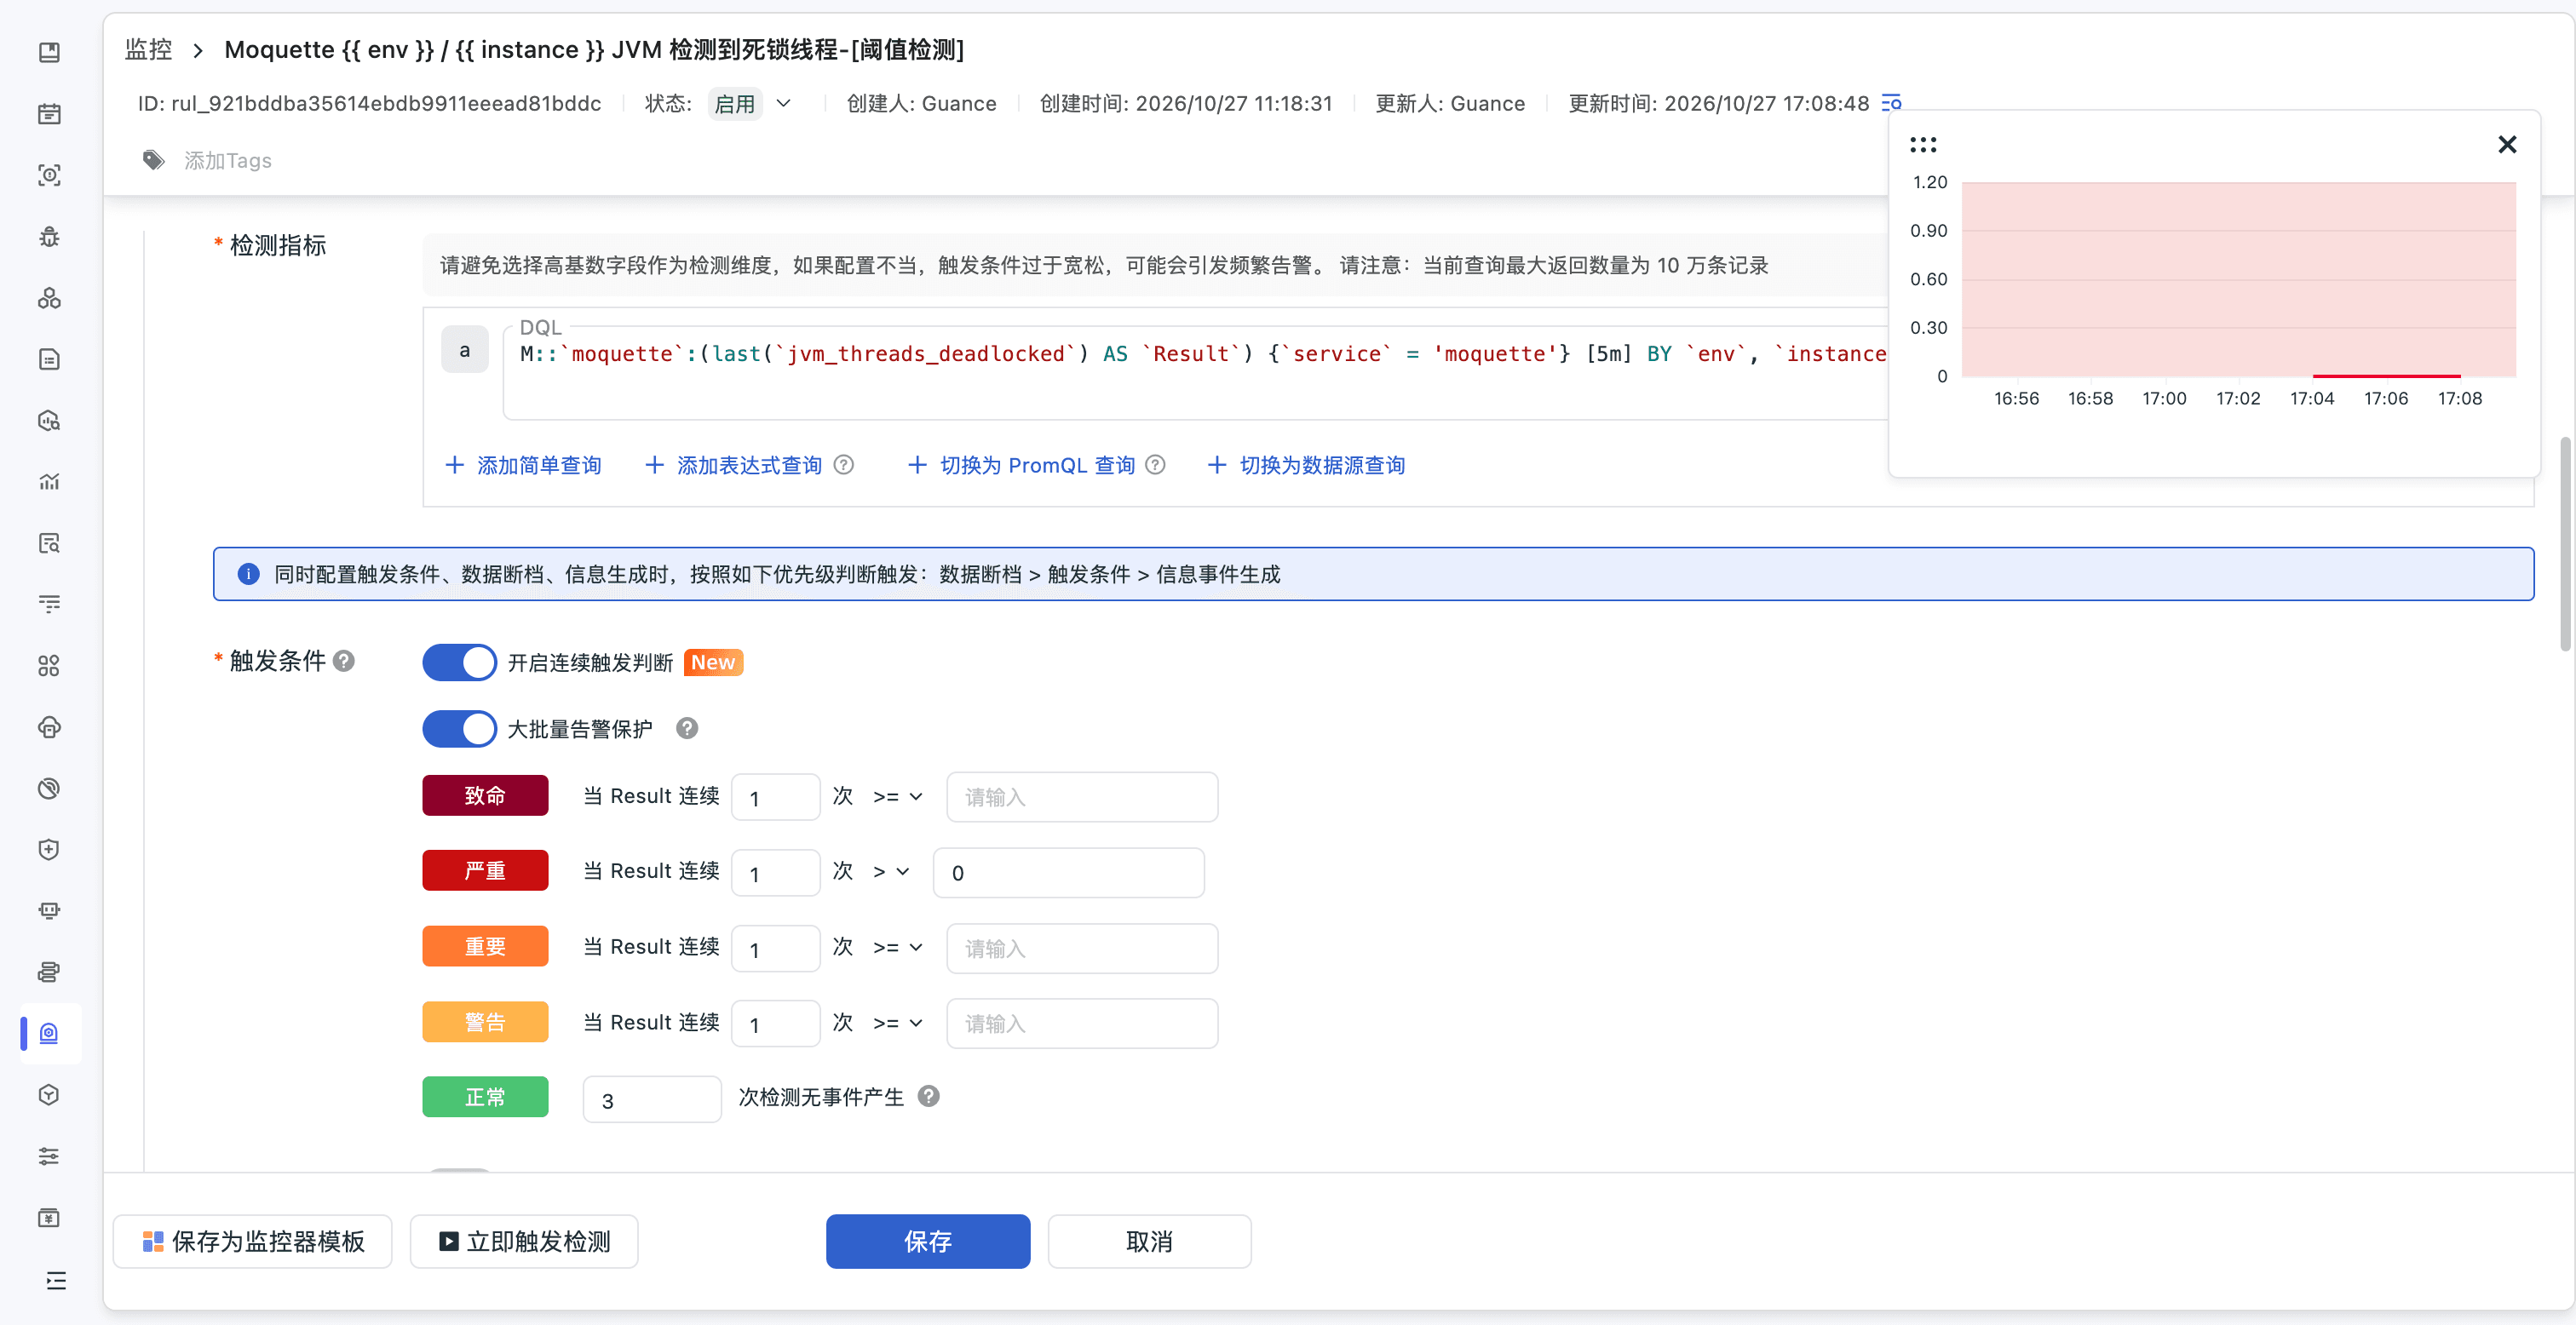
jvm_threads_deadlocked |
检测到的死锁线程数,大于 0 时需要及时排查。 | 个 |
process_cpu_seconds_total |
进程累计 CPU 时间;每秒速率可表示占用的 CPU 核数。 | s;速率为核 |
process_resident_memory_bytes |
进程常驻内存,用于观察实际驻留的物理内存规模。 | B |
process_open_fds process_max_fds |
已打开与允许打开的最大文件描述符数量,用于评估描述符余量。 | 个 |
jvm_runtime_info |
值为 1,JVM 版本、厂商及运行环境记录在标签中。 | 信息指标 |
场景视图
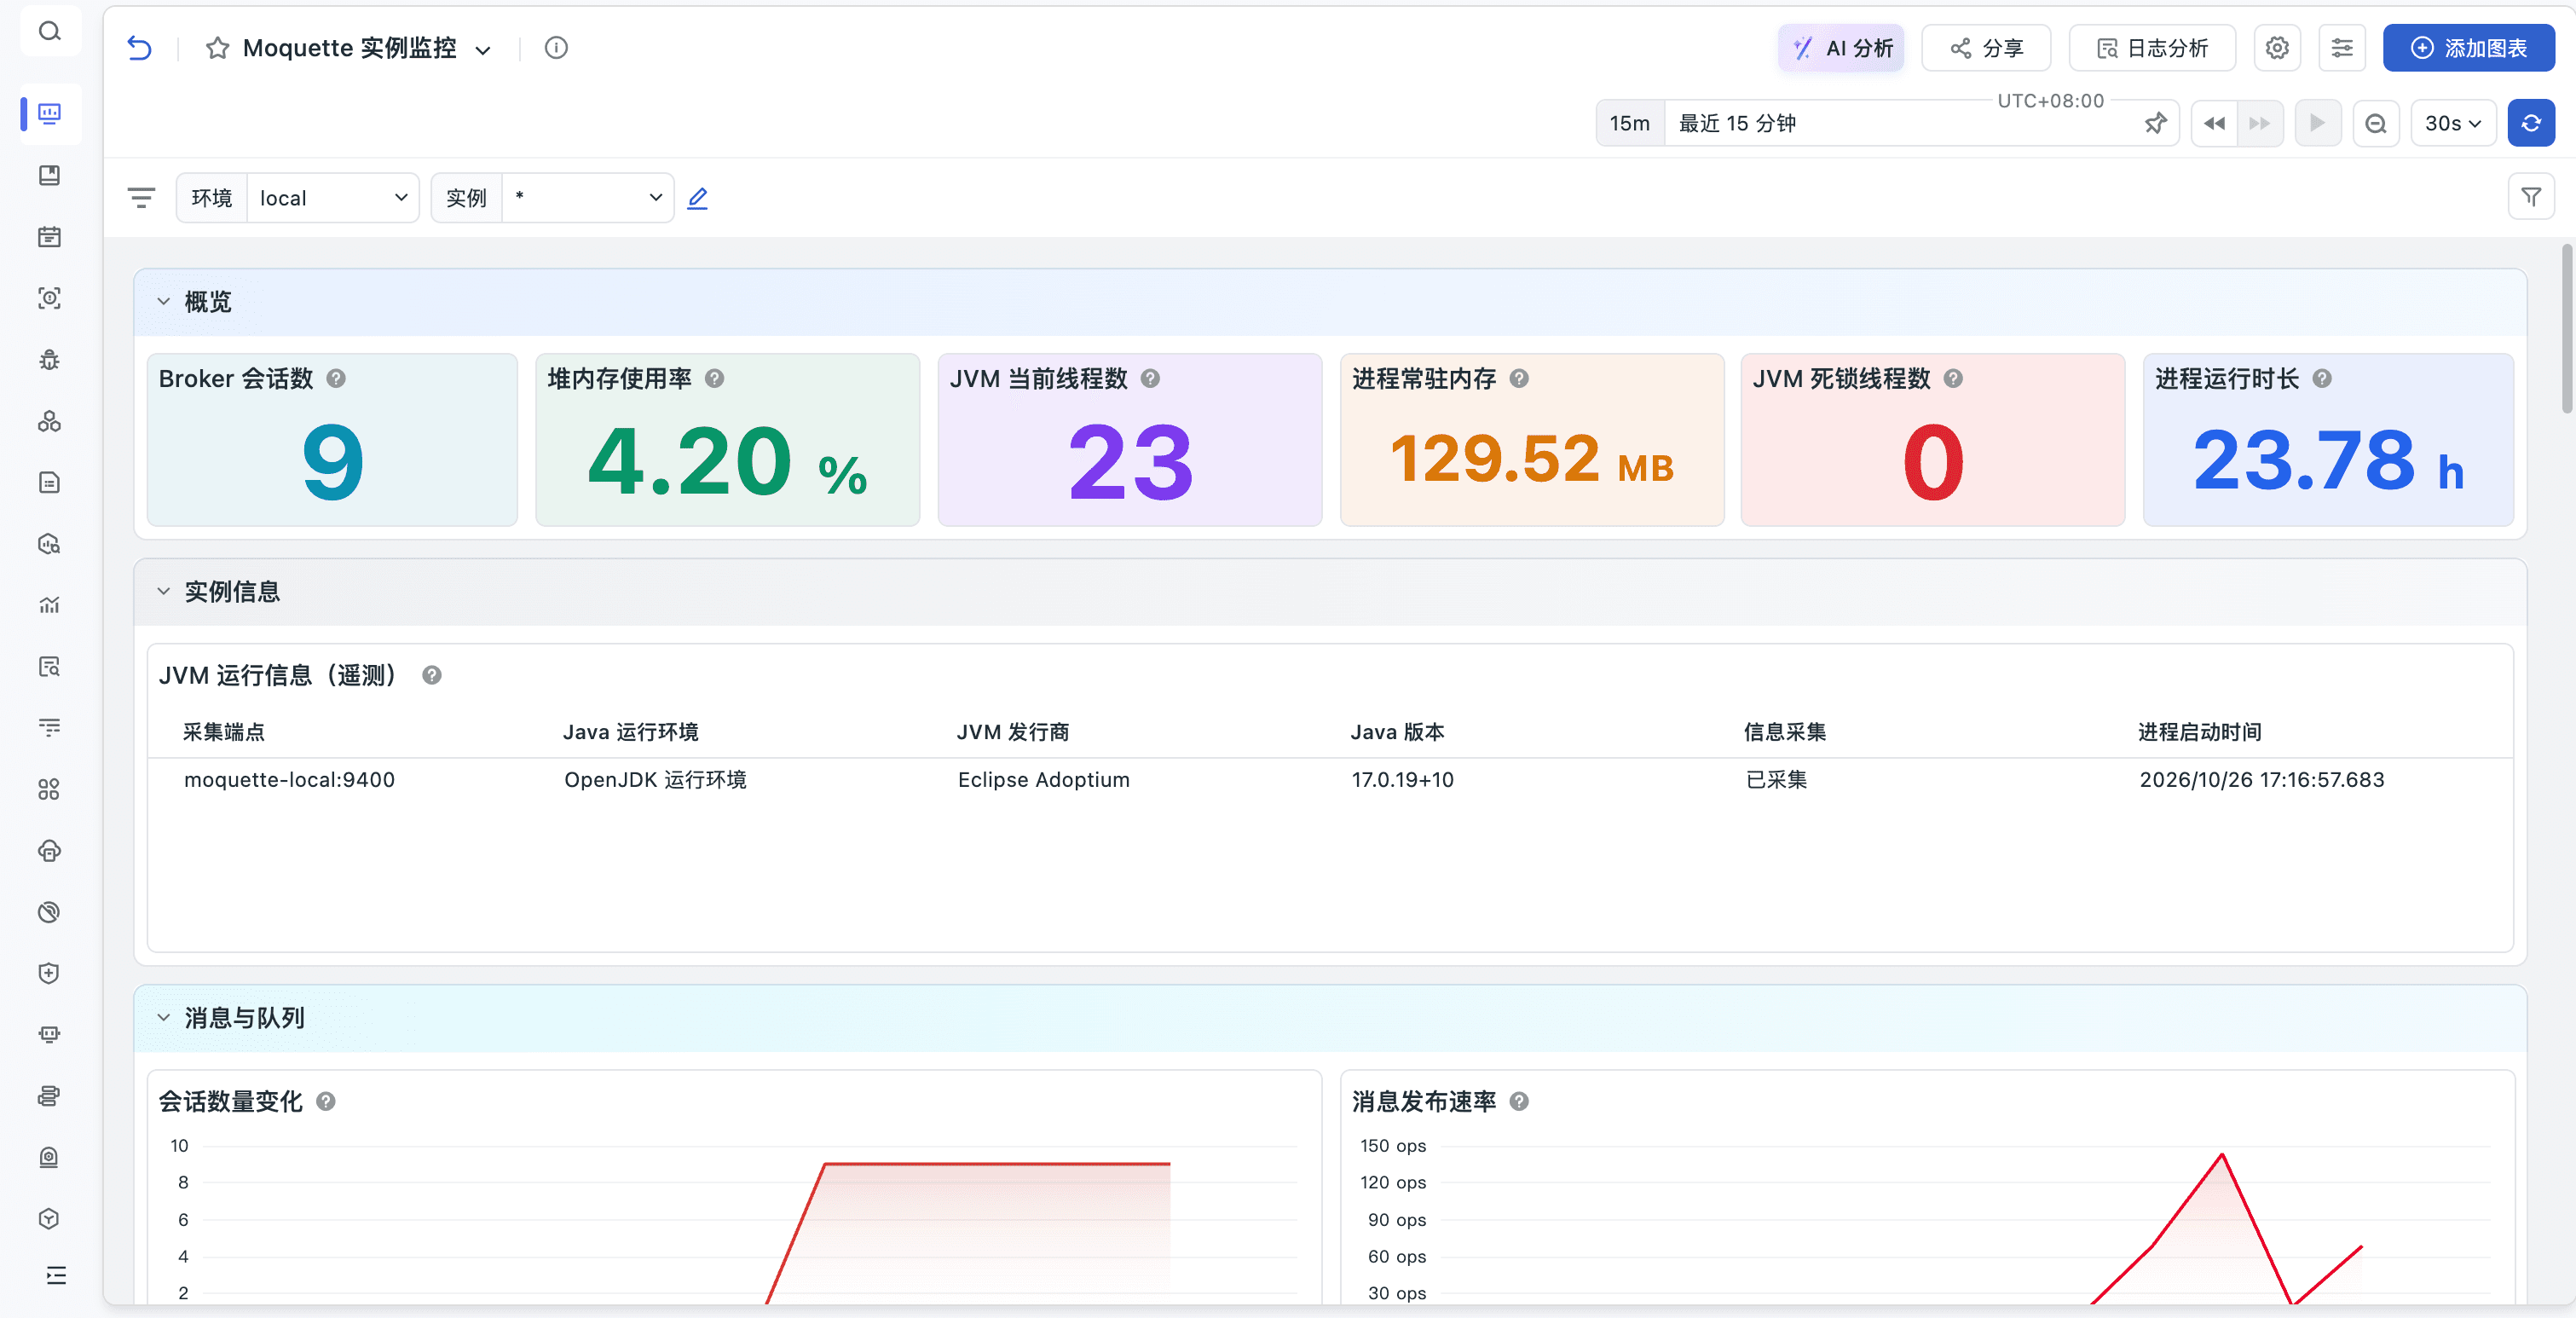
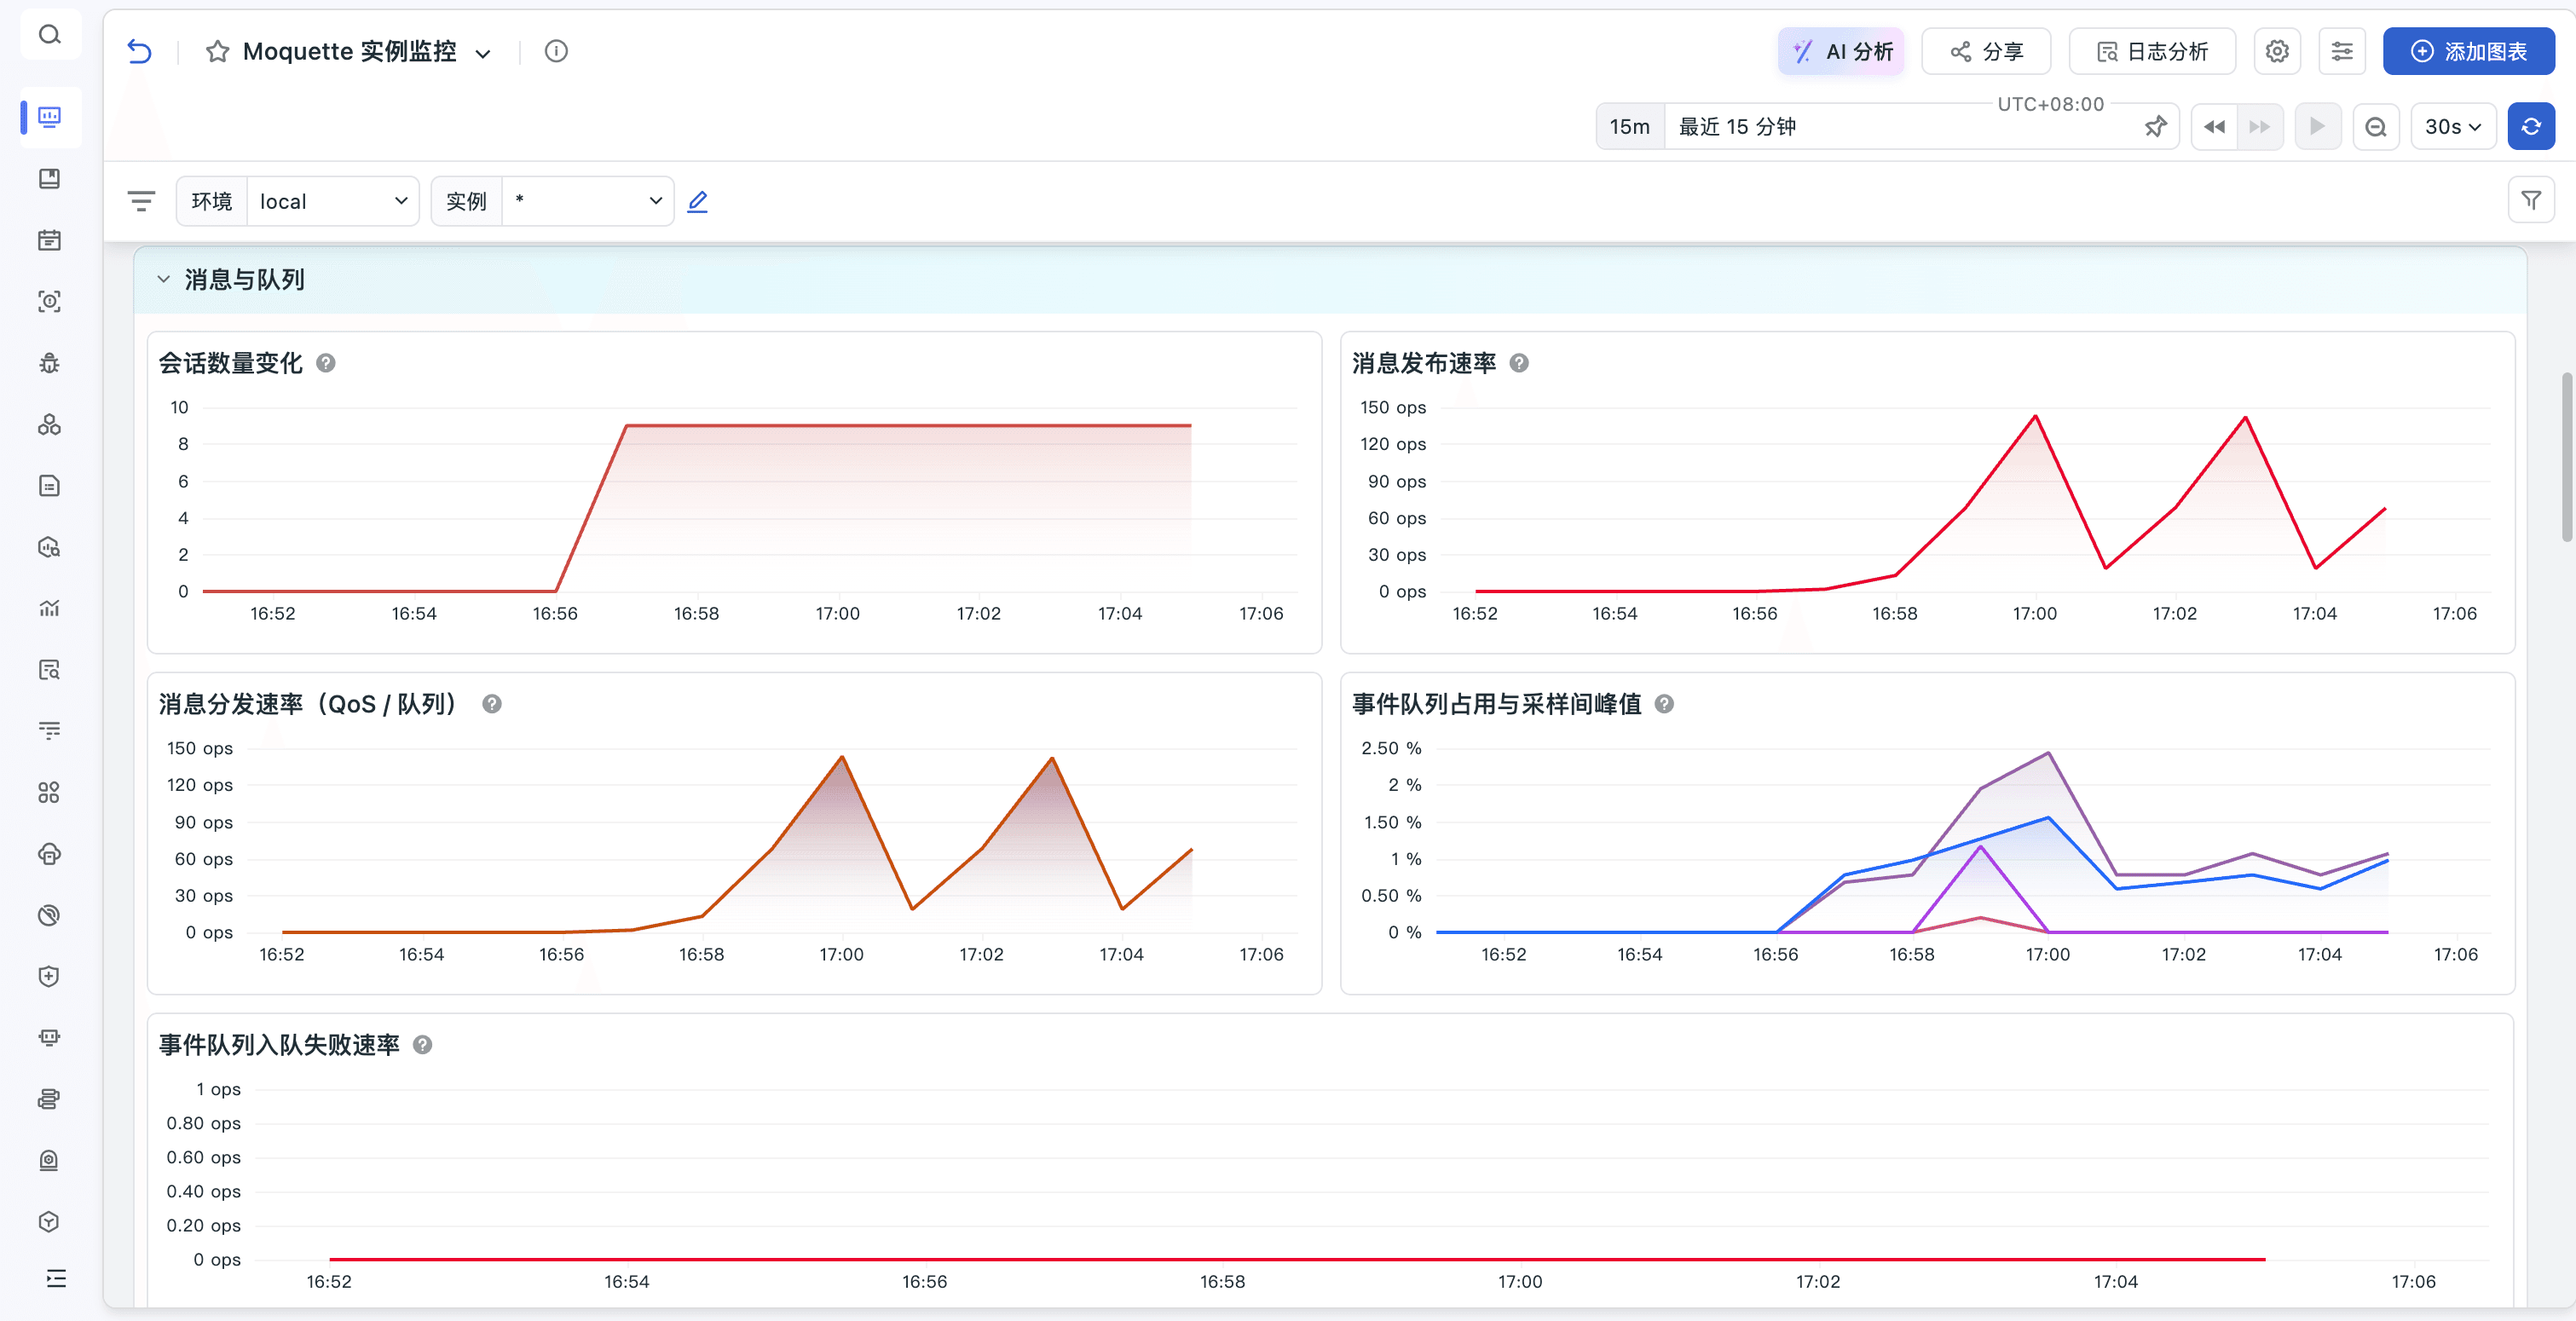
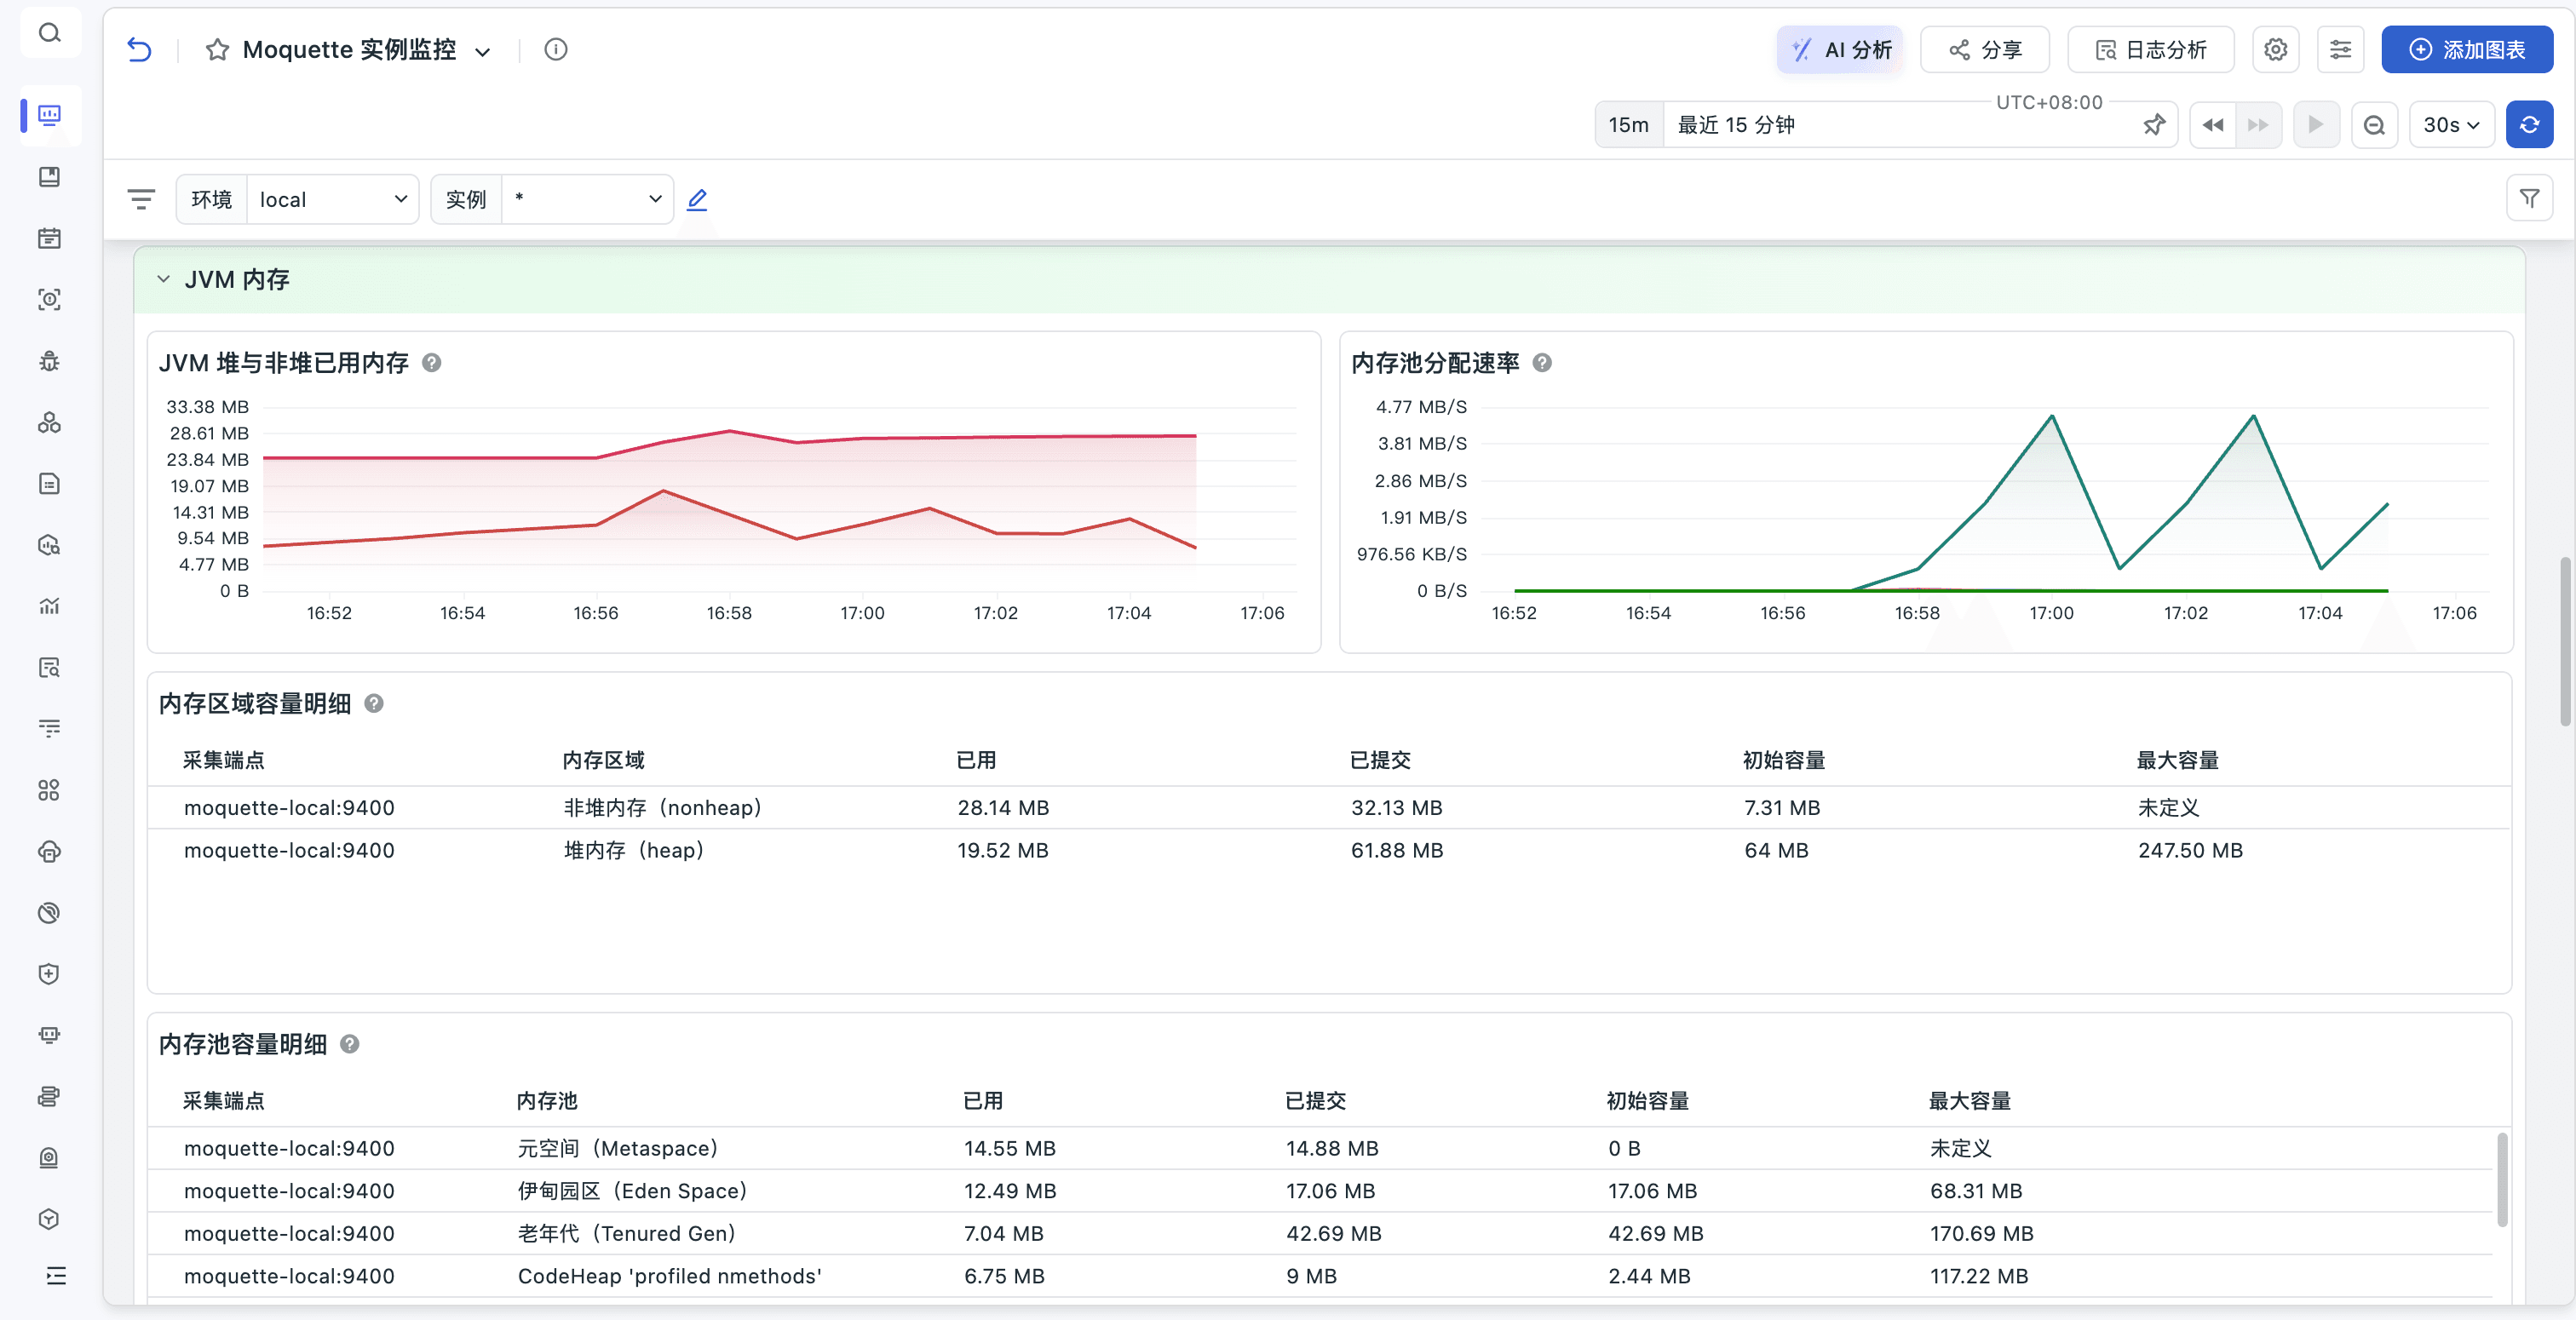
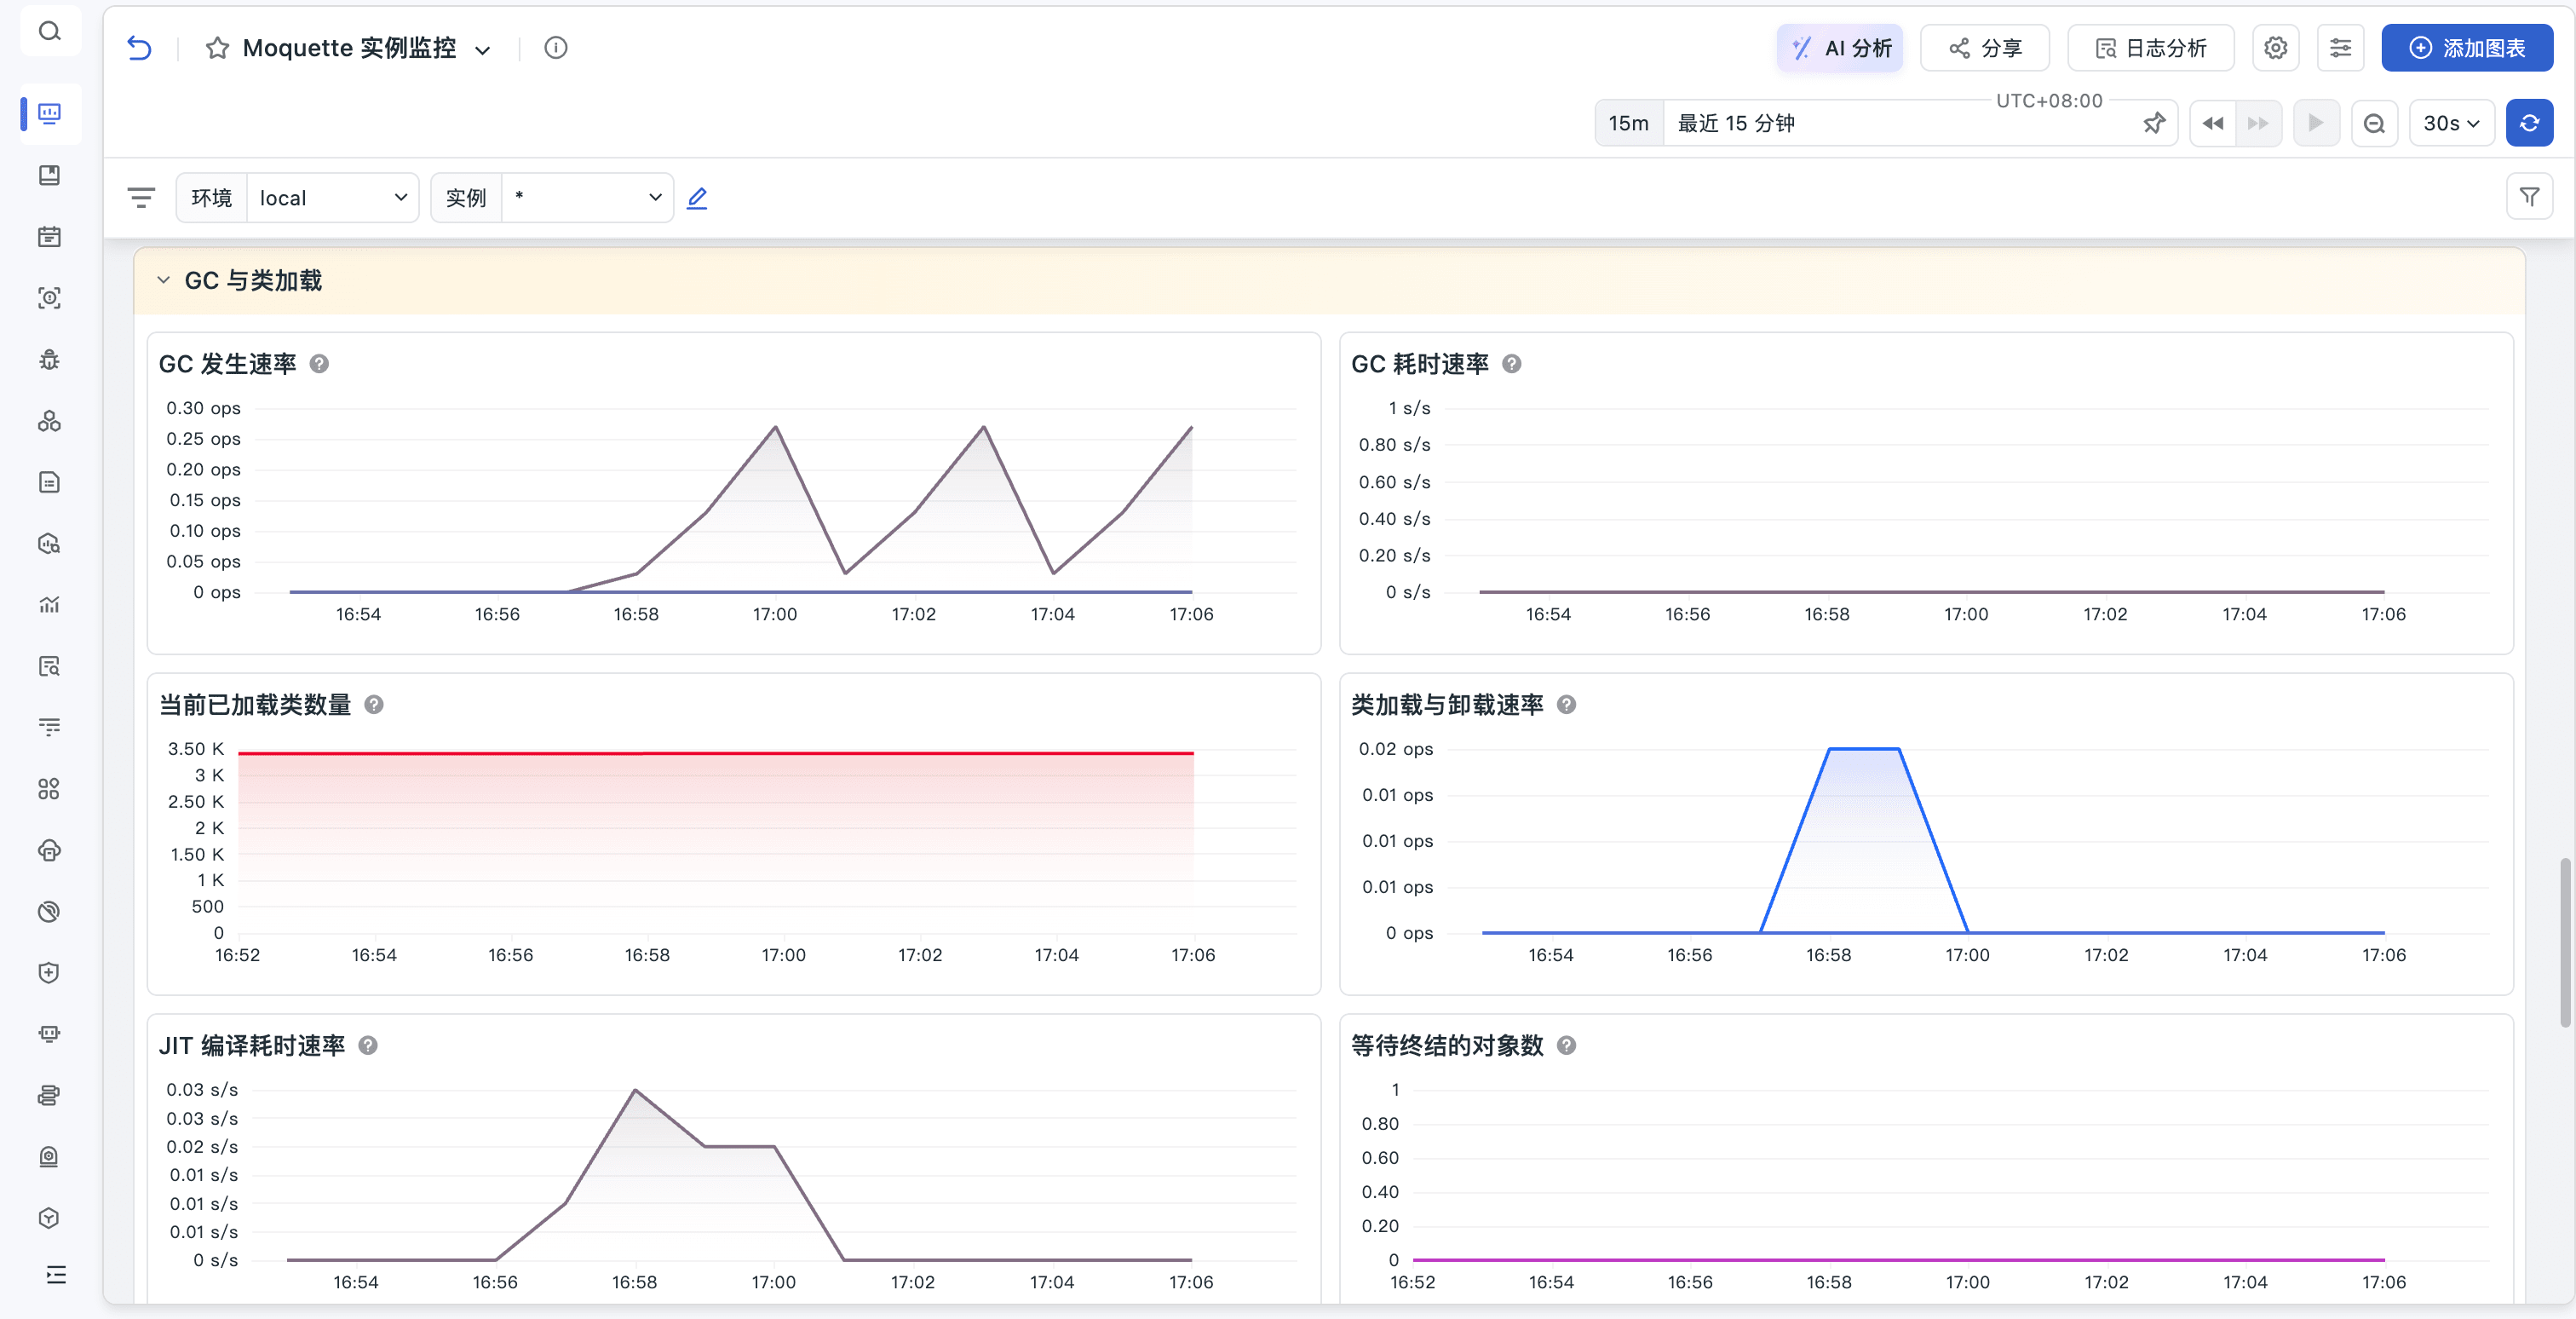
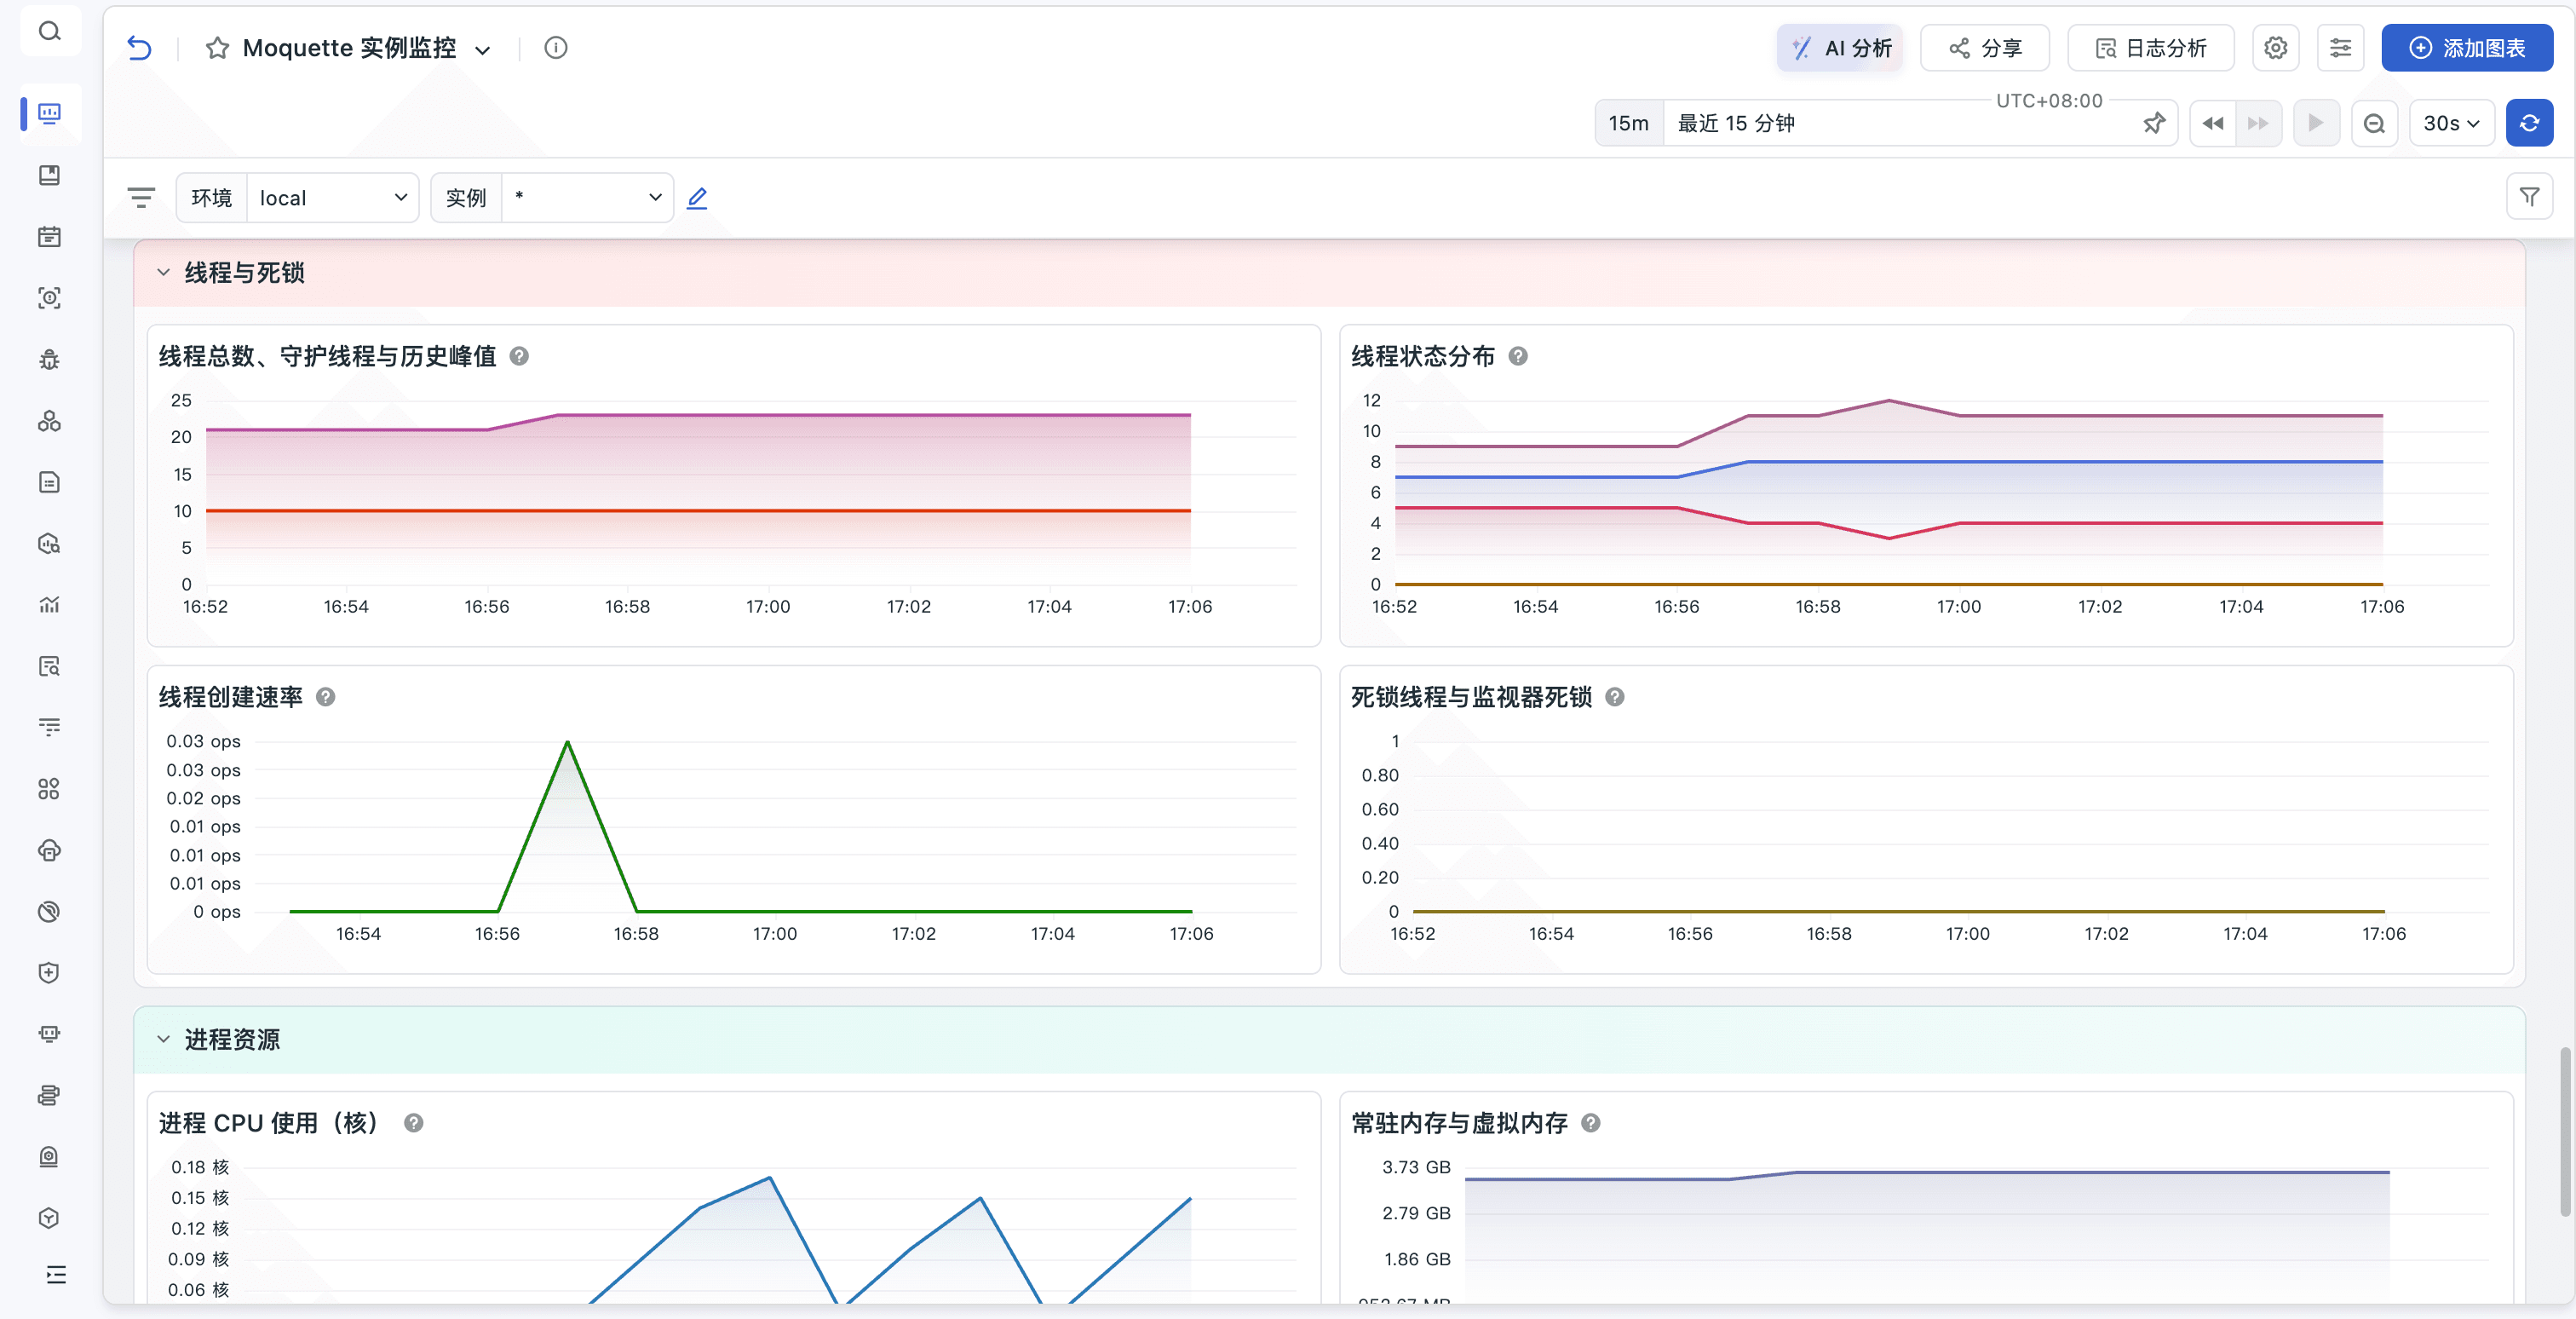
登录观测云控制台,进入「场景」创建仪表板,导入本次集成配套的 Moquette 实例监控 Dashboard。
监控器(告警)
在观测云「监控」中导入配套监控器 。
JVM 死锁告警
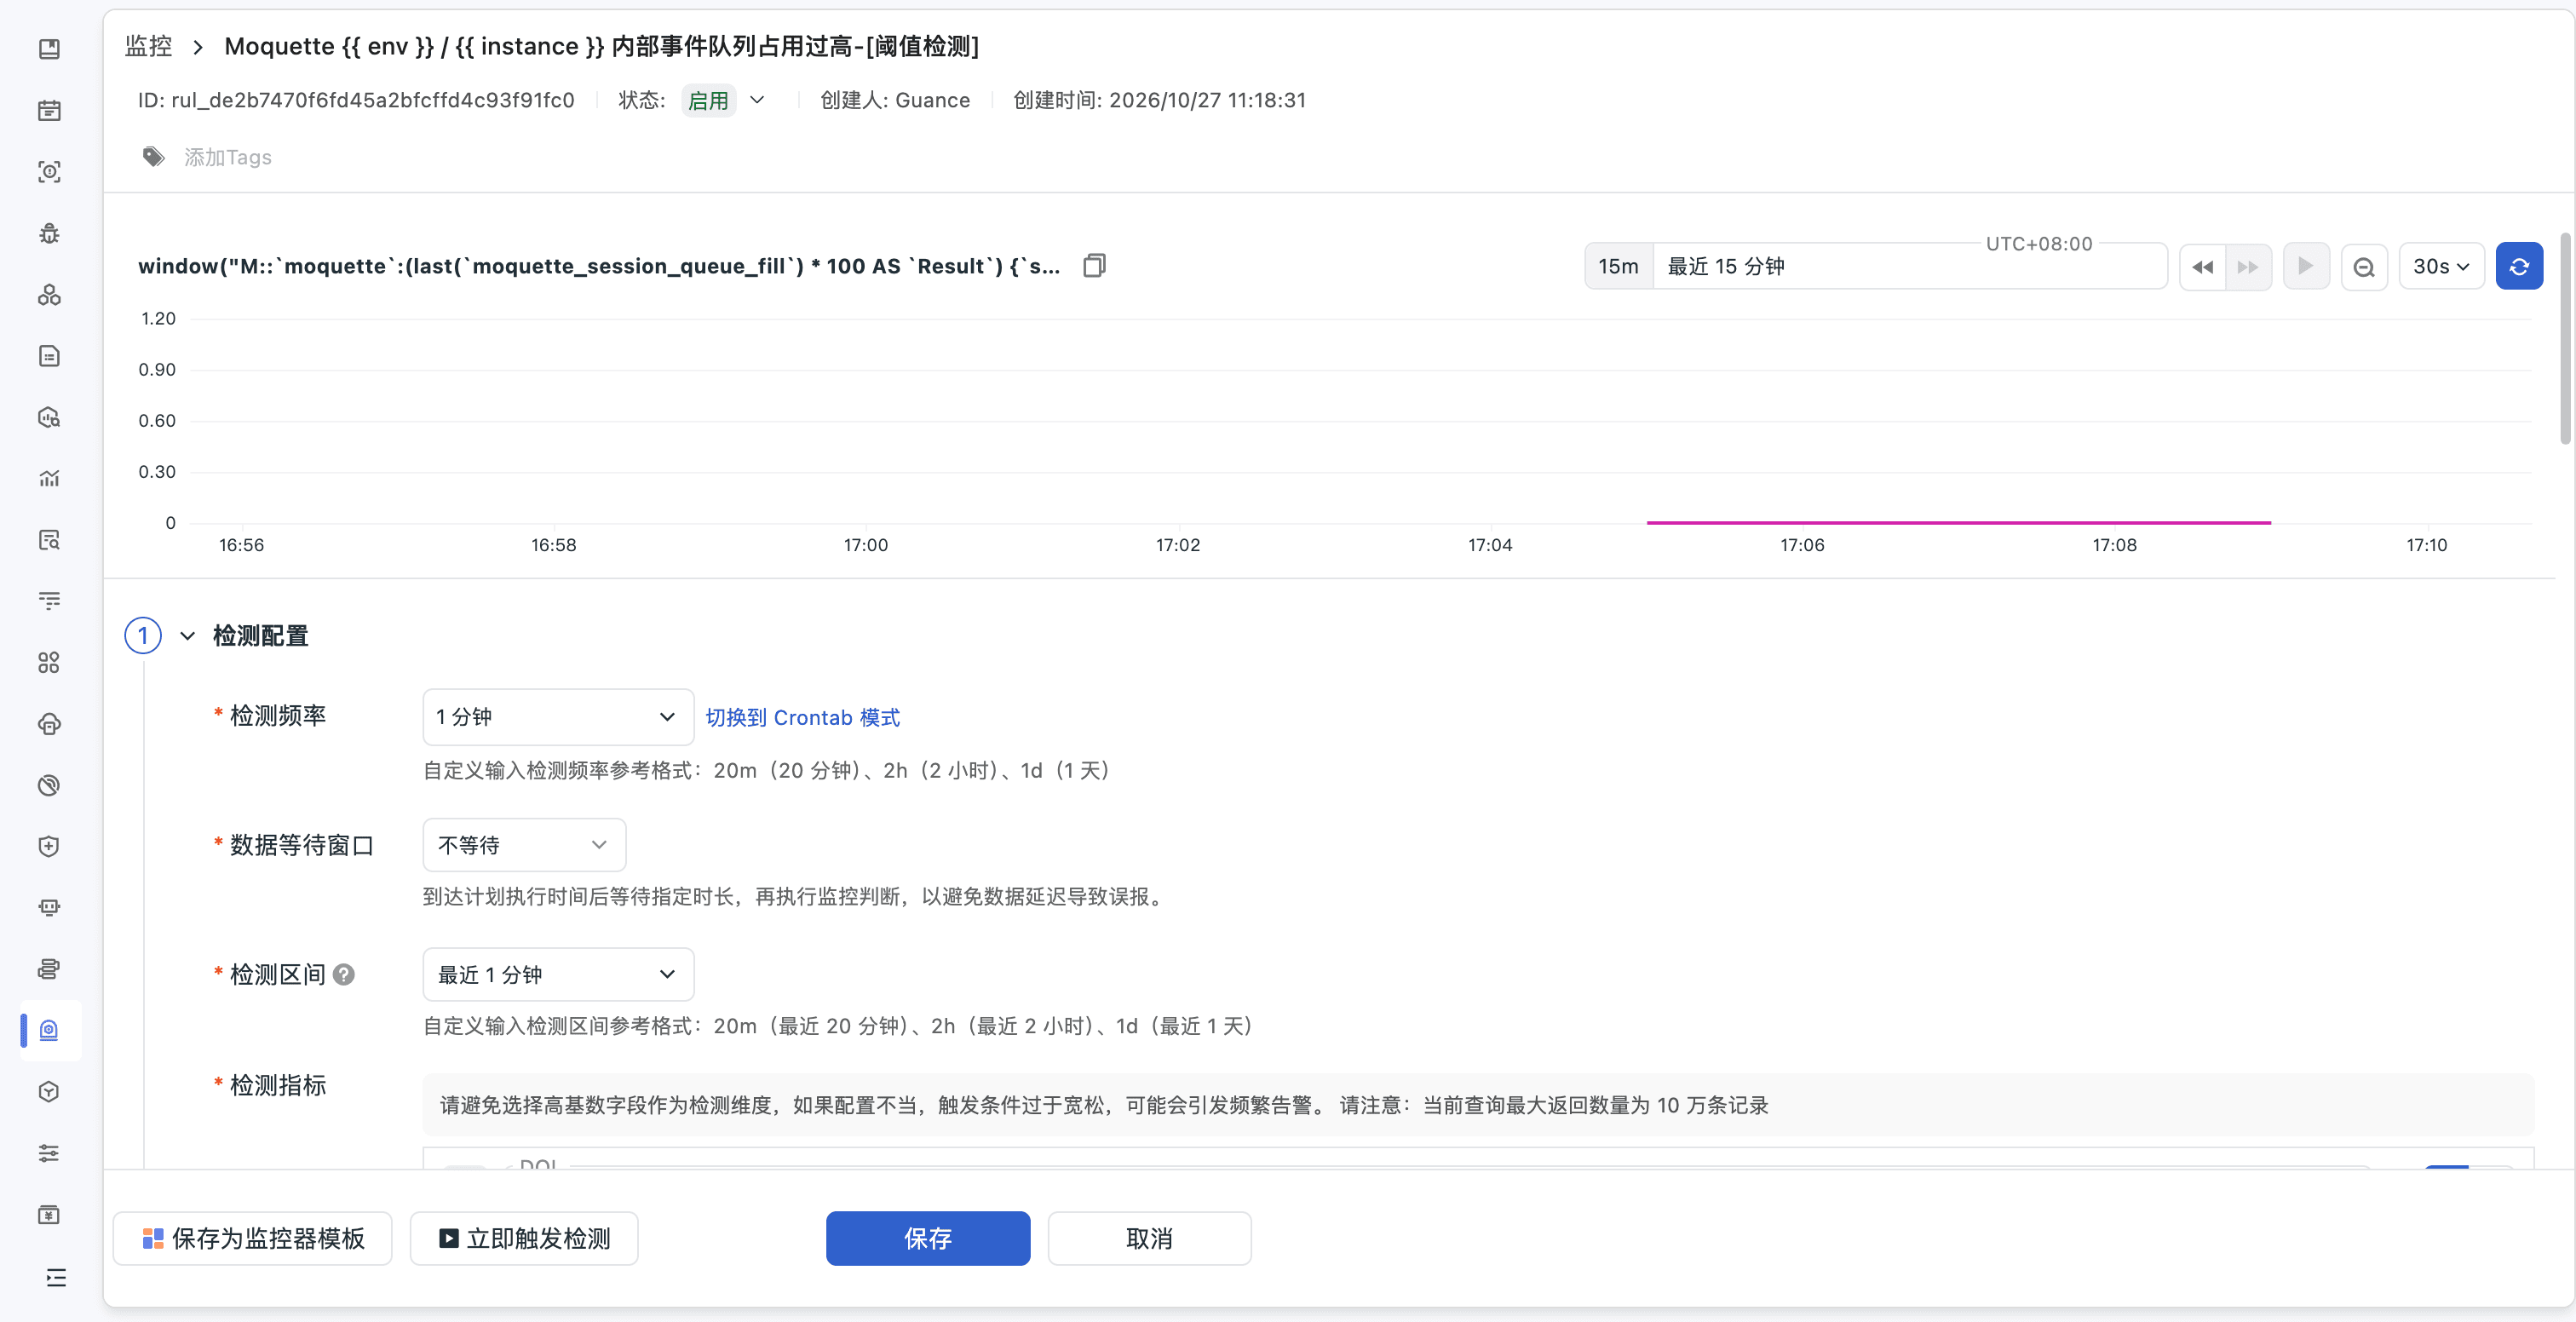
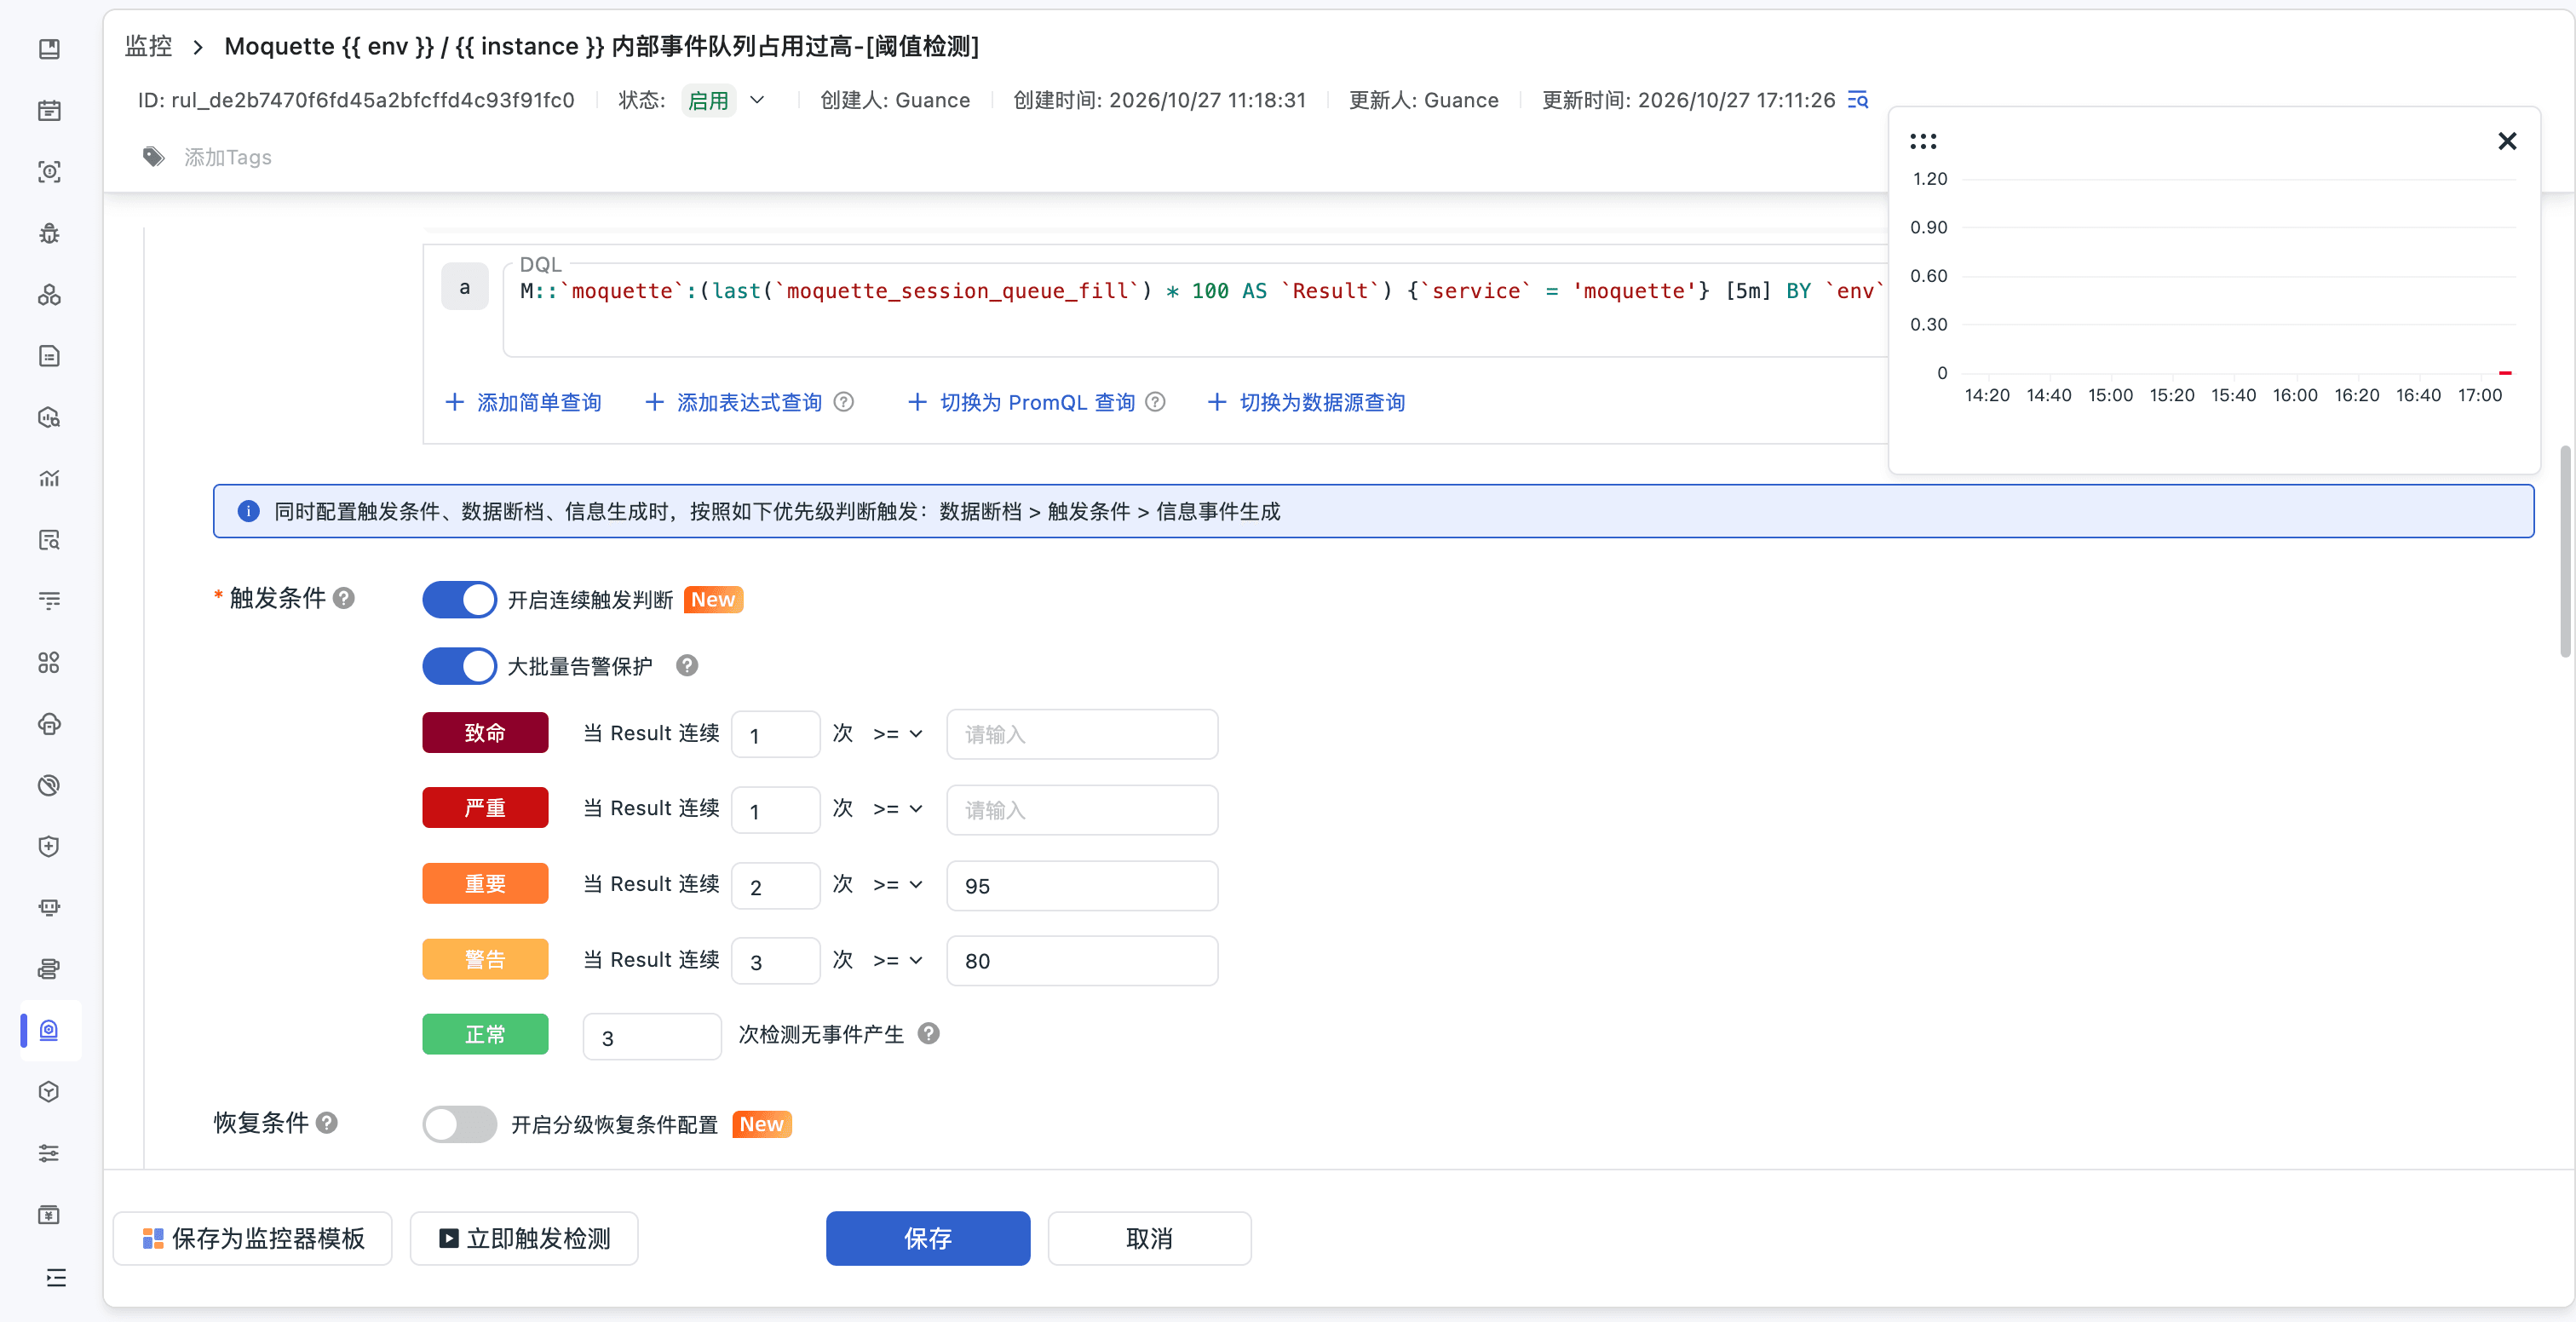
内部事件队列占用过高告警
总结
通过 Moquette 原生 Prometheus 指标与 DataKit,能够在观测云中统一查看消息负载、内部事件队列以及 JVM 和进程资源。排查时可从会话与发布量开始,沿队列、GC、内存和线程逐步缩小范围,使业务变化与资源变化形成可对照的证据。
落地时应保持指标名称、指标集和环境标签与模板一致,并根据业务基线调整告警阈值。对当前占用、窗口峰值、累计计数和速率分别解释,才能正确理解图表中的 0 值与波动,让仪表板和告警为容量观察与故障排查提供可靠依据。